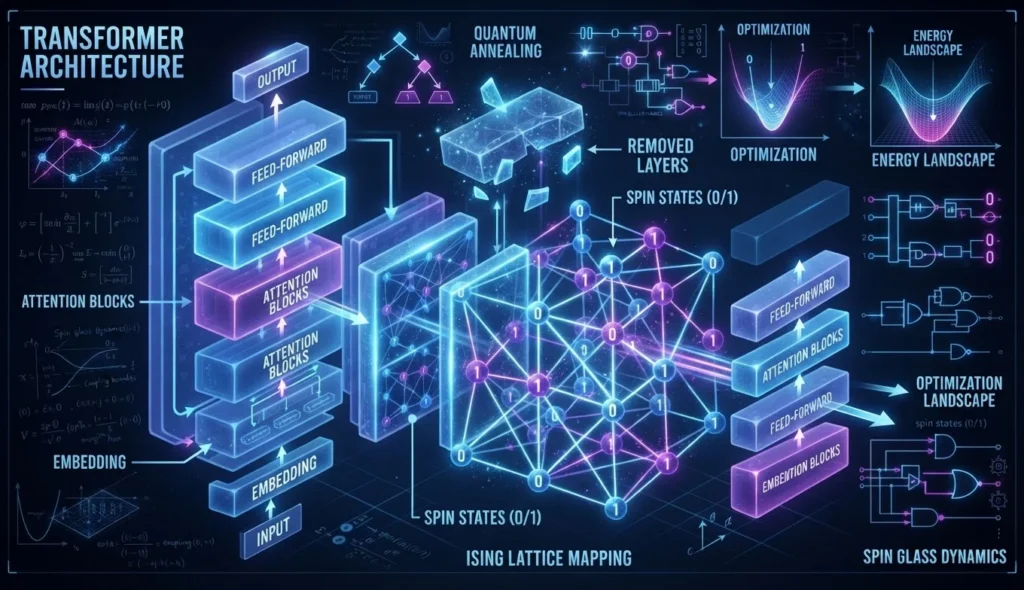
Multiverse Computing 团队提出将删除整块 Transformer 模块的组合优化问题映射为受约束的 Ising/QUBO 形式,借助 Hessian 二阶近似捕捉模块间耦合,并用精确或启发式求解器搜索低“能量”剪枝配置,在多项基准上比传统按层评分的方法显著保留模型能力,尤其在高比例深度压缩下差距最大。
Hugging Face 社区博客 9 月 21 日刊登的一篇来自 Multiverse Computing 团队的文章提出,删除大语言模型的整块 Transformer 模块,不应只是给每个模块单独打分后“挑最不重要的删除”,而可以被视为一个带约束的组合优化问题。研究团队把这一问题映射为物理学中的 Ising 玻璃模型,并称在 Llama-3.3-70B-Instruct 深度压缩至保留一半模块时,模型在 MMLU 上较现有模块删除方法高出近 23 个百分点。
这项工作的技术细节来自论文《LLM Compression by Block Removal with Constrained Binary Optimization》。论文由 Multiverse Computing 的 David Jansen、Roman Rausch、Ali Hashemi、David Montero,以及 Donostia International Physics Center 和 Ikerbasque 的 Román Orús 合作完成。论文最初于 2026 年 1 月提交,9 月 11 日修订至 v3;Hugging Face 的团队文章则在 9 月 21 日发布。两者是同一研究方向的不同发布节点,日期不应混为一谈。
删除整块模块,为什么不是简单的排序问题
所谓 block removal,也称 depth pruning,是直接从模型中删除完整的 Transformer 模块。与删除单个权重相比,这种方式更容易带来可预测的推理加速:模型层数变少,内存占用也会下降,而且可以与量化、低秩压缩和知识蒸馏叠加使用。
但模块之间并不是相互独立的。删除第 20 个模块造成的影响,可能取决于第 19 个或第 24 个模块是否也被删除。传统的幅值、敏感度或 block influence 方法通常对每个模块单独评分,或者只考虑删除一段连续模块。这些做法降低了搜索成本,却也忽略了模块之间的相互作用。
Multiverse Computing 团队将这种关系类比为统计物理中的多体问题:单个自旋的状态并不能决定整个系统的能量,周围自旋之间的耦合同样重要。对于需要一次删除大量模块的模型压缩任务,这种耦合可能成为决定结果的关键因素。
用 Hessian 近似建立 Ising“能量”
研究团队为每个 Transformer 模块设置一个二元变量:0 表示保留,1 表示删除。随后,他们对模型损失相对于这些变量进行二阶 Taylor 展开,得到一个近似 Hessian 矩阵。
矩阵的对角项反映单个模块的重要性,非对角项则描述模块之间的成对耦合。研究团队据此构造出一个带约束的二元优化问题:在 N 个模块中恰好删除 M 个模块,并让目标函数 xᵀH⁰x 尽可能低。这个问题可以转换为固定磁化强度的 Ising 玻璃,也可以写成 QUBO 形式。
关键假设是,较低的“能量”通常对应下游任务表现更好的剪枝配置。这样,研究人员便可以先用廉价的能量计算对大量候选组合排序,而不必逐一运行完整模型并进行基准测试。Hessian 只需通过校准数据集上的前向和反向传播计算一次,之后还可以复用于不同的压缩比例。
精确搜索之外,也可以使用启发式求解器
当候选空间仍然可枚举时,团队使用单张 GPU 进行暴力搜索。文章称,删除 Llama-3.3-70B 的 80 个模块中的 8 个,会产生约 290 亿种配置,最困难的可验证案例大约耗时两天。
更大的搜索空间无法依靠穷举解决,因此研究团队把同一问题交给禁忌搜索、分支定界、量子退火和 QAOA 等经典、量子及量子启发式求解器。论文称,开源禁忌搜索求解器在数秒内就能找到与最低能量状态接近的解。
研究团队还强调,实际应用并不总需要找到严格意义上的基态。只要能够快速产生一批低能量候选配置,再从中实际评测,往往就足以找到高质量模型。这也是他们认为轻量级启发式求解器具有实用价值的原因。
最低能量状态不一定是最好的模型
这项研究一个较有意思的结论是,最低能量配置并不总是最终表现最好的配置。由于能量只是下游能力的代理指标,低能量谱中其他“激发态”也可能包含更好的剪枝方案。
以 Llama-3.1-8B-Instruct 为例,研究团队考察了删除 32 个模块中的 16 个的情形。多数低能量配置倾向于删除模型后部模块,但排名第 17 的激发态首次提出删除靠近模型前部的模块。经过轻量再训练后,该配置在多个基准上超过了基态方案。
这意味着,剪枝搜索不应只输出一个答案,也不应预先假设最优策略一定是删除中段或后段的一段连续模块。对实践者而言,保留多个低能量候选,再结合目标任务进行复测,可能比盲目追求单一全局最优解更稳妥。
50% 深度压缩时,差距明显扩大
论文和团队文章给出的最突出结果来自未再训练的 Llama-3.3-70B-Instruct。在原始模型 MMLU 得分为 82.2 的条件下,删除 80 个模块中的 32 个时,CBO 方法得分为 76.6,block influence 基线为 59.3;删除 40 个模块、也就是进行 50% 深度压缩时,CBO 得分为 76.9,而基线降至 54.0。
换算为两种方法之间的差距,后一个设置约为 22.9 个百分点,也就是文章所称的“近 23 个百分点”。需要注意,这不是说压缩模型超过了原始模型,而是说在同样的深度压缩条件下,CBO 配置比对照方法更好地保留了能力。
在较轻的压缩比例下,差距没有那么明显。研究团队报告称,Qwen3-14B 在删除 40 个模块中的 12 个时,CBO 在 MMLU 上领先约 10 个百分点;在 Llama-3.1-8B-Instruct、Qwen3-14B 和 Llama-3.3-70B-Instruct 的部分轻度压缩设置中,两种方法表现相近。这也符合耦合效应的直觉:删除的模块越多,组合选择的重要性越高。
方法也适用于混合专家模型
为了检验方法是否依赖于均匀的 Transformer 堆叠结构,研究团队还在 NVIDIA Nemotron-3-Nano-30B-A3B-FP8 上进行了测试。该模型混合使用 Mamba2、注意力模块和混合专家层,结构并不均匀。
CBO 不要求所有模块具有相同类型,因此可以直接用于这种异构架构。论文称,在不再训练的情况下,删除 2 个注意力层或 3 个 MoE 层时,CBO 配置在 AIME25 和 GPQA 上超过了 block influence 方法。不过,具体结果会随着删除的位置和模块类型显著变化,不能据此推断所有混合架构都能获得同样收益。
这项研究的边界在哪里
首先,近 23 个百分点是相对于另一种模块删除基线的差距,不是独立第三方对所有剪枝方法的统一排名。其次,论文中的许多结果使用的是研究团队选择的模型、校准数据集和基准组合;实际部署时,能量代理与真实业务指标之间的相关性仍需单独验证。
其次,删除模块带来的推理收益也不等于端到端成本会按相同比例下降。实际效果还取决于推理框架、批处理方式、显存容量、硬件利用率,以及模型是否需要再训练或重新校准。类似地,底层算子优化带来的收益也往往需要结合具体设备和运行时验证;例如,Hugging Face 近期发布的 207 个 WebGPU 内核显示,单个操作的加速并不自动等于完整模型的端到端加速。
最后,Ising 或量子启发式表述本身并不意味着必须使用量子硬件。该研究的核心是把模块间的二阶相互作用显式纳入优化,并利用适合组合问题的求解器。与 DeepSeek 将稀疏注意力的候选筛选下沉到 DeepSelect CUDA 内核类似,这里的重点也是把模型效率问题转化为更具体、可测量的工程优化问题。
对大模型部署者来说,研究提供的实际启示可能不是“用物理学取代所有剪枝方法”,而是:当压缩比例足够高、模块之间的相互作用不能再被忽略时,先建立一个可重复计算的组合搜索空间,再从低能量候选中进行任务级验证,可能比单独给每一层排序更有机会保住模型能力。