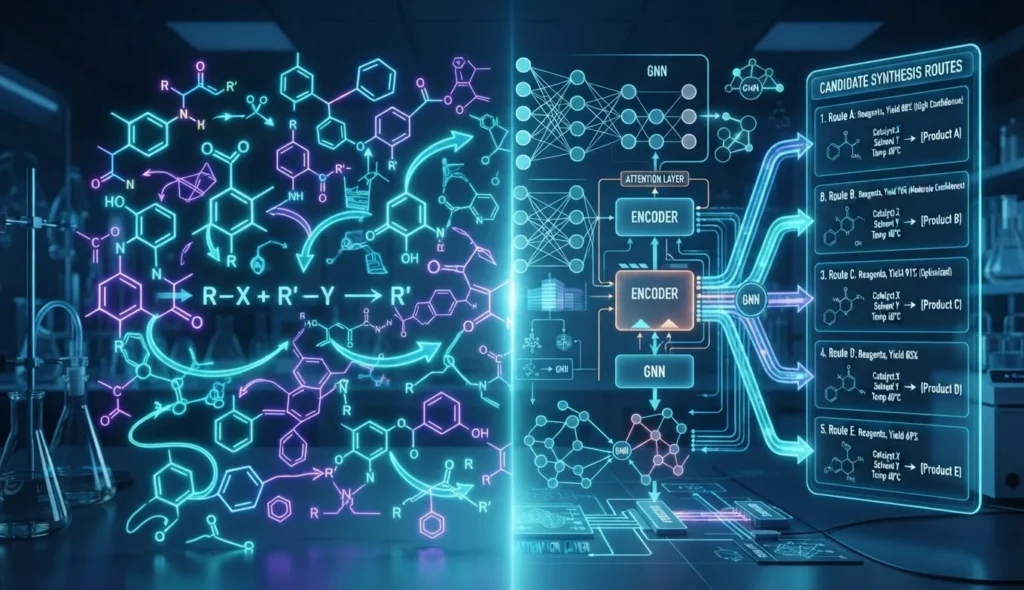
微软研究院开源RetroChimera,一套用于小分子逆合成规划的集成AI模型与权重并发表在《Nature》。该系统通过组合生成模型R-SMILES 2和图神经网络模型NeuralLoc来提升合成路线预测的接受度,但微软强调仍需实验验证与工艺优化,模型更适合作为早期筛选工具而非替代实验。
微软研究院于2026年9月21日公布 RetroChimera,一套用于小分子逆合成规划的人工智能模型,并开放了实现代码与模型权重。该项目当天也随相关论文发表于《Nature》。微软称,RetroChimera在由博士级有机化学家参与的盲测中获得了较高接受度,但公司同时强调,模型预测不能直接等同于已经完成的化学实验,也不能替代后续的实验验证、工艺优化和药物开发流程。
逆合成规划的思路,是从一个目标分子出发,反向推断可以将其拆解成哪些更简单的前体分子,再逐步寻找能够落到可购买原料的完整路线。对药物、先进材料和农业化学品而言,这一步往往决定了一个候选分子是否值得继续研究。问题在于,一个目标分子通常存在大量可能的断键方式,而真正可行的路线还必须满足反应条件、原料可得性、步骤数量和化学选择性等约束。
两种模型处理不同类型的化学不确定性
RetroChimera的核心不是单一模型,而是把两种具有互补偏差的模型组合起来,再通过学习到的排序策略对结果重新排名。
其中,R-SMILES 2是基于Transformer的从头生成模型,直接根据目标分子生成可能的前体分子。它不必严格局限在已提取的反应模板中,因此有机会覆盖训练数据中较少见、甚至没有明确模板记录的反应类型;但由于生成空间更开放,也可能提出化学上不合理的结果。
NeuralLoc则以图神经网络为基础,同时编码目标分子和反应模板,并预测模板应当作用于目标分子的具体位置。这样的设计更贴近训练数据中已有的化学反应模式,通常能够提供更受约束的预测,但当目标反应超出模板库范围时,灵活性也会受到限制。
微软研究院表示,R-SMILES 2尤其擅长反应前后发生较大结构变化的情形,而NeuralLoc在低频反应和局部结构变化方面更有优势。RetroChimera通过学习不同模型在不同排名位置上的可信度,综合两者的输出;当两个模型提出相同反应时,集成结果还可以利用这种一致性进一步提高排序。
专家盲测显示较高接受度,但测试范围有限
根据微软对论文实验的概述,在单步反应预测的盲测中,博士级化学家对RetroChimera预测结果的接受度高于其两个子模型、一个基线模型以及测试集中的文献反应。对于10个具有挑战性的目标分子,模型给出的完整合成路线中有9条获得专家接受;相比之下,从头生成模型、编辑模型和NeuralSym基线模型分别有5条、4条和2条路线被接受。
这些结果说明,模型在特定评测设置下更接近化学家的判断,也显示出集成不同建模方式的价值。不过,单步预测或完整路线被专家接受,并不意味着路线已经在实验室中成功执行。逆合成搜索通常会递归调用单步模型,一步预测中的错误可能在多步路线中累积,最终使整条路线失效。因此,专家评价、公开数据集测试和真实实验之间仍然存在明确区别。
《Nature》论文还报告了模型在不同数据规模和数据划分下的表现,包括对训练分布之外情形的鲁棒性、从每类反应少量样本中学习的能力,以及在两家大型制药公司的内部数据集上进行零样本迁移和微调的实验。内部数据集的结果表明,模型具备在分布变化下进行泛化的潜力,但这些结果来自论文所描述的特定企业数据和验证条件,不能直接推导为所有制药公司的实际效果。
开源让模型进入科研工作流,也带来新的验证要求
微软已在GitHub仓库中以MIT许可证开放RetroChimera的实现与权重,并在Microsoft Foundry模型目录提供访问入口。微软研究院还介绍,公开检查点基于Pistachio、USPTO-50K和USPTO-FULL等数据集训练,研究人员可以将其用于路线评估,并与其他分子生成或性质预测工具结合使用。
开放代码和权重的意义,在于研究人员可以检查模型实现、复现实验,并针对自己的分子数据进行测试或微调。这也使模型更容易嵌入药物发现和材料设计的早期流程:研究人员可以先用模型扩大候选路线空间,再由化学家筛选其中更有希望的方案,最后通过实验确认反应是否能够按预期发生。
这类“从聊天到科研执行”的工作流正在生命科学领域逐渐成形。例如,AIFlux此前报道过ChatGPT与Codex如何被嵌入抗菌分子筛选流程,但这类案例的共同边界是:AI可以扩大搜索范围、处理数据和提出候选方案,实验室仍必须负责验证、优化和排除错误结果。诺和诺德与Anthropic探索将模型用于药物研发的进展也表明,制药企业更关注模型能否稳定进入受监管的研发流程,而不仅是一次演示中的输出质量。
从“提出路线”到“做成分子”仍有很长距离
RetroChimera解决的是合成规划中的一部分问题,而不是完整的自动化药物发现。一个模型提出的前体组合,仍需要化学家检查反应条件、原料来源、立体化学和安全风险;路线进入实验阶段后,还要面对产率、纯化、放大生产、成本和可重复性等现实约束。
更重要的是,药物或材料候选物最终是否有价值,取决于它们在实验中的性质,而不是路线预测本身。对药物而言,活性、毒性、稳定性、药代动力学和临床效果都需要独立验证;对材料和农业分子而言,也必须检验性能、环境影响以及制造条件。
因此,RetroChimera的实际影响可能首先体现在早期筛选效率上:它帮助研究人员更快比较更多合成路线,并把专家时间集中到最值得验证的候选方案上。它并没有消除化学合成的失败率,而是尝试把人工经验、反应模板和开放式生成能力放进同一个排序框架中。
对于人工智能制药和材料科学而言,下一步值得关注的并不是模型在单一基准上的排名,而是它在不同实验室、不同分子空间和真实多步合成中的可重复性。只有当模型建议能够持续转化为可执行、可解释并经过实验确认的路线时,逆合成模型才可能从研究辅助工具进一步成为可靠的科研基础设施。
来源:
- 微软研究院:Improving synthesis prediction of small molecules at scale with RetroChimera
- Nature:Chemist-aligned retrosynthesis by ensembling diverse inductive bias models
- 论文预印本:Chemist-aligned retrosynthesis by ensembling diverse inductive bias models
- Microsoft Research publication page
- 微软官方GitHub仓库:microsoft/retrochimera
- Microsoft Foundry:RetroChimera