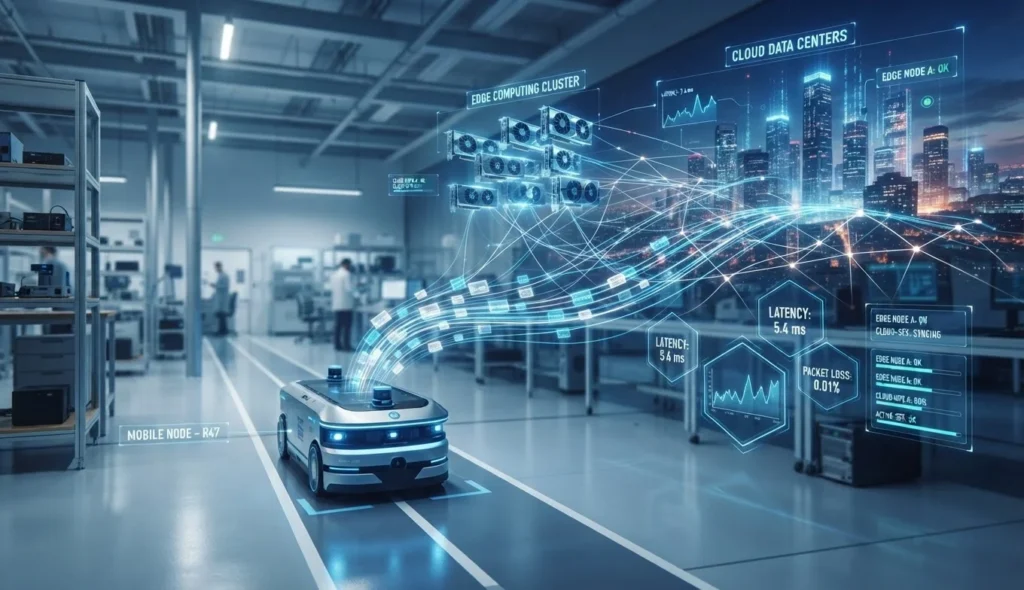
微软研究院测量了将移动机器人上的物理 AI 推理部分卸载到边缘或云端 GPU 的效果,发现卸载能缓解机载算力与电池限制,但受网络延迟、带宽、视频压缩和多机器人共享资源等因素显著制约。研究并随同发布了 Physical AI Toolchain 开源工具链,提出从本地开发到边缘/云端扩展的实践路径与资源管理建议。
微软研究院在9月23日发布一项关于移动机器人操作任务的研究,认为把部分物理 AI 推理从机器人搭载的 GPU 转移到边缘或云端 GPU,可以缓解机载算力在性能、功耗和模型规模上的限制。研究同时强调,推理卸载并不是简单地把计算搬到远端:网络延迟、带宽、视频压缩以及多台机器人共享 GPU,都会影响最终效果。
这项研究的核心论文是微软发布的技术报告 《Offload or Overload: A Platform Measurement Study of Mobile Robotic Manipulation Workloads》。论文于2026年3月18日提交至 arXiv,研究团队由 Sara Pohland、Xenofon Foukas、Ganesh Ananthanarayanan、Andrey Kolobov、Sanjeev Mehrotra、Bozidar Radunovic 和 Ankit Verma组成。
机载 GPU 的两难:算力不足,或电池消耗过快
研究聚焦于移动机器人操作,也就是机器人在现实空间中完成感知、规划、导航和抓取等连续任务。微软举出的典型场景是“在厨房里找到垃圾并把它放进垃圾桶”:机器人需要规划路线、识别目标、避开障碍、完成抓取,再返回指定位置。
研究团队在 SO-101、TurtleBot 4 和 Stretch 3 等不同形态的机器人上,对比了机载 GPU、边缘 GPU 和云端 GPU。测试覆盖语义建图与规划、导航以及视觉语言动作模型等工作负载,使用的计算平台包括 Jetson Orin、Jetson Thor、L4、DGX Spark 和 NVIDIA A100。
微软表示,部分较小的机载 GPU 甚至无法容纳完整的移动操作模型栈。在能够运行这些模型的情况下,建图与规划速度相较 A100 最多慢383%;轻量 GPU 对导航中及时发现障碍物的能力造成约30%的下降;视觉语言动作模型虽然没有出现同等幅度的速度下降,但延迟足以令准确率下降约50%。
这些数字是微软研究团队在特定硬件、模型和任务组合下的测量结果,并不意味着所有机器人平台都会出现相同幅度的变化。研究报告的结论更接近于:机器人设计者需要在模型精度、响应速度、功耗和设备成本之间作出系统性取舍,而不是单独追求更大的机载 GPU。
电池是另一项限制。微软称,在一项测试中,用 Raspberry Pi 5 负责轻量级数据传输、把推理交给远端 GPU后,机器人可以减少机载计算负担;相比之下,较大的机载 GPU(例如 Jetson Thor)在较大型机器人上也可能令电池消耗增加最多160%,相当于缩短数小时续航。这个结果同样只适用于研究中的设备和配置,不能直接视为任何机器人产品的通用续航提升。
卸载推理并非没有代价
微软技术报告也没有把边缘或云端推理描述成无条件的解决方案。研究发现,即使增加几十毫秒的网络延迟,也可能使机器人操作准确率下降超过10%。如果机器人持续把摄像头画面传输到远端 GPU,网络带宽也可能成为瓶颈;对视频流进行压缩,则可能使操作和语义建图准确率下降接近20%。
这意味着远端 GPU 的选择必须与网络环境一起评估。在仓库、工厂或医院等场景,靠近机器人部署的边缘 GPU可能比跨区域云端连接更适合闭环控制;而对延迟不那么敏感的高层规划任务,云端计算则可能更具弹性。
当多台机器人共享同一组边缘或云端 GPU 时,系统还可以通过批处理和统计复用减少所需计算资源,但并发增加也会推高推理时间和网络延迟。报告因此提出,面向机器人集群的卸载系统需要准入控制或更细致的资源管理,才能为高优先级任务保留性能保证。
Physical AI Toolchain 把卸载机制接入机器人工作流
与研究同步,微软在 Physical AI Toolchain 中加入面向物理 AI 推理卸载的能力。微软称,这套开源工具链使用容器、Kubernetes、ROS 2 和 LeRobot 等组件,把机器人、边缘基础设施与云端之间的训练、评估和推理工作连接起来。
根据微软研究院的 官方介绍,开发者可以通过声明式配置指定需要卸载的工作负载,工具链随后为远端 GPU生成独立容器,并利用 Kubernetes进行部署和调度。微软还提供了 SO-101 和 Universal Robots UR10e 的示例项目,并展示了将面向双臂机器人的 Rho 模型部署到 Jetson Thor、驱动 Mobile Aloha机器人完成操作的演示。
不过,工具链的开源仓库也显示,这是一套覆盖不同部署规模的基础设施,而不是要求所有用户一开始就搭建完整云端系统。仓库将本地单机器人开发列为 T0起点,云存储、Kubernetes、Azure Machine Learning 和跨站点部署等能力按更高层级逐步加入。换言之,微软提出的是一条从本地开发到边缘和云端扩展的路径,而不是宣布所有物理 AI机器人已经完成云端部署。
机器人计算架构正在从“单机”转向“分布式”
物理 AI模型越来越依赖视觉语言动作模型和更大规模的世界理解能力,单纯增加机载 GPU会同时带来重量、成本、散热和续航问题。微软这项研究的价值,在于把这些问题放到完整的机器人系统中衡量:模型速度会影响控制闭环,网络质量会影响卸载收益,多个机器人共享资源又会改变系统容量。
这也使得物理 AI 的基础设施竞争不再只围绕模型或机器人本体展开。像 NVIDIA 推出的 Cosmos 3 Edge边缘物理 AI模型,代表一种尽量把实时推理留在现场的路线;而 LeRobot v0.6的闭环机器人学习工具链则强调训练、评估、部署与数据反馈之间的循环。微软的方案更进一步讨论了如何在机器人、边缘节点与云端之间动态分配推理任务。
对机器人制造商和部署方而言,真正需要回答的问题不是“推理应该放在机器人上还是云端”,而是哪些任务必须在本地完成、哪些任务可以容忍网络往返,以及在电池、带宽和 GPU资源有限时如何维持安全和稳定的控制。微软的研究提供了一个测量框架,但能否在具体工厂、仓库或家庭环境中获得同样的收益,仍取决于机器人型号、无线网络、任务类型和远端算力配置。
来源: