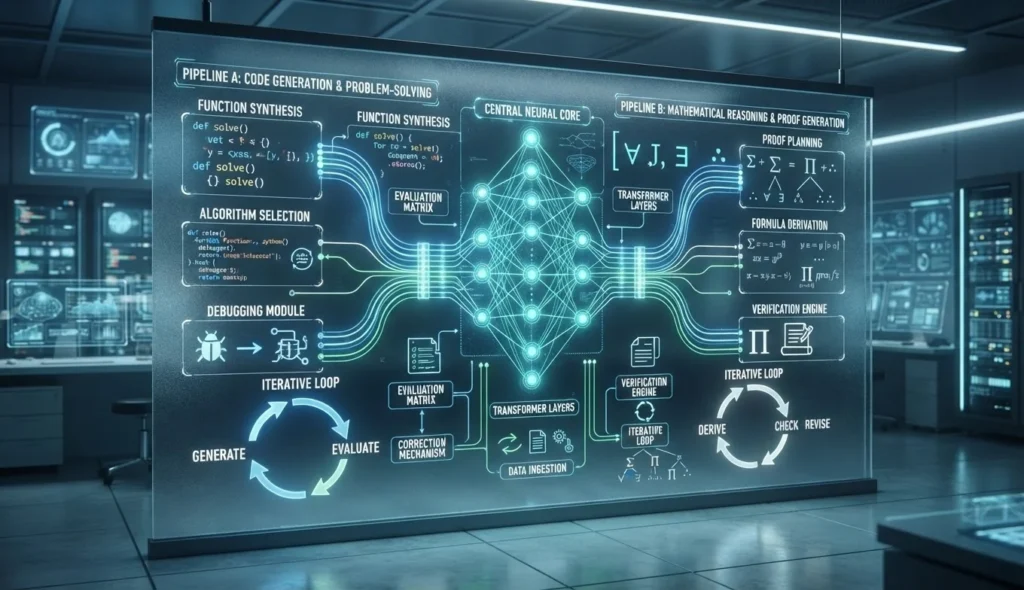
英伟达团队基于 Nemotron 3 系列,通过 SFT、RL 与生成—验证—修正(GenCorrect)推理循环,将同一模型家族专业化后,在 IOI 和 IMO 非官方/半官方测试中分别达到了金牌线成绩,展示了模型、训练数据与测试时推理协同的重要性。团队已在 Hugging Face 和开源仓库公开模型、数据与推理配方,但复现仍需大量计算资源与完整评测条件。
英伟达研究团队表示,他们从 Nemotron 3 基础模型出发,通过监督式微调(SFT)、强化学习(RL)以及生成—验证—修正的推理流程,分别在 2026 年国际信息学奥林匹克竞赛(IOI)和国际数学奥林匹克竞赛(IMO)中取得达到金牌线的成绩。
根据 Hugging Face 上英伟达团队于 2026 年 10 月 7 日发布的原始文章,用于 IOI 的 Nemotron-3-Ultra-CC 得分为 535.4 分(满分 600 分),高于 361.12 分的金牌线和最高人类选手的 498.27 分。用于 IMO 的系统得分为 42 分中的 30 分,高于官方 29 分的金牌线。
这两项结果并不意味着模型已经在所有意义上取代了竞赛选手。IOI 的测试是在比赛期间进行的实时、前瞻性运行,但属于非官方、无人监督的基准测试,成绩没有计入 IOI 官方排名;IMO 的证明则由官方 IMO 评分员批改。两项成绩的测试条件和证据性质,需要与“赢得正式比赛”区分开来。
从编程竞赛到数学证明:同一套思路的两种应用
IOI 和 IMO 考察的能力并不相同。IOI 要求参赛者设计能够通过隐藏测试的算法,并在严格的时间和提交限制下编写代码;IMO 则要求参赛者用自然语言给出严谨、完整的数学证明。
英伟达团队将这两个项目放在同一条技术路线下理解:先选择能力较强的基础模型,再准备特定领域的问题和推理轨迹,随后使用标准的后训练方法进行专业化,最后让模型与一个能够反复生成、评价和改进候选答案的推理系统结合起来。
团队总结的流程包括四个环节:
- 使用能力较强的 Nemotron 基础模型;
- 筛选领域问题,并准备高质量推理轨迹;
- 使用 SFT,并在合适的场景加入 RL;
- 把模型接入能够生成、评估和改进答案的推理循环。
因此,金牌线成绩并不是单纯由一次微调或一次大规模采样产生。模型、训练数据和测试时推理流程被作为一个整体共同设计。
IOI:22,000 道题与 GenCorrect 推理循环
在竞争性编程项目中,团队整理了 22,000 道题,并生成合成推理轨迹,用于训练两个专业化模型。
Nemotron-3-Nano-CC 总参数量为 300 亿,激活参数量为 30 亿,同时接受了 SFT 和 RL;Nemotron-3-Ultra-CC 总参数量为 5500 亿,激活参数量为 550 亿,主要接受 SFT。团队在相关论文中将这套方法描述为一个结合问题整理、合成推理数据、后训练和测试时计算的端到端流程。
在 IOI 2025 的实验中,Nano 模型在后训练前得到 130 分,经过 SFT 后升至 280 分,加入 RL 后达到 291 分。接入 GenCorrect 后,它的成绩达到 468 分,超过当年的 438.3 分金牌线。Ultra-CC 在同一测试时策略下达到 502 分。
GenCorrect 是这一流程的关键组成部分。它不是简单地让模型多生成几份答案,而是让模型根据评估反馈反复生成、检查并修正候选程序。在 2026 年 IOI 的实时运行中,比赛专用的 Ultra-CC 系统最终得到 535.4 分。
英伟达团队表示,不同规模的模型并不需要完全相同的适配方案。对于 Nano,SFT 带来了主要收益,RL 进一步带来较小但稳定的提升;对于更强的 Ultra 模型,一轮 SFT 就足以让它在 IOI、ICPC 和 LiveCodeBench Pro 等测试中超过完成全部后训练的 Nano 模型。
IMO:让模型生成、检查并修正证明
数学项目采用了类似的结构,但训练数据和评估环节围绕自然语言证明展开。
团队从 Nemotron 3 Ultra 出发,分别训练了一个 SFT 专业模型和一个 RL 专业模型。SFT 数据集包含 414,890 个经过质量筛选的样本,覆盖 15,818 道不同的证明题。数据不仅包括最终答案,还包括证明生成、证明修订、验证和元验证,使模型能够尝试构造论证、发现漏洞、回应批评,并判断一个证明是否完整。
RL 模型则使用了 9,597 道接近模型能力边界的证明题进行训练。开发阶段的结果显示,两个专业模型各有优势:SFT 模型在搜索的第一轮表现较好,RL 模型在单个检查点的总体结果上更强。最终系统因此同时使用两个专业模型和通用模型,而不是只依赖某一个检查点。
对每一道 IMO 题目,系统会生成多个候选证明,对候选进行评分和批评,再修正最有希望的答案。随后,一个使用更多计算资源的阶段负责挑选最终提交内容。
据团队介绍,整个系统只使用自然语言工作,没有形式化证明器、外部工具或互联网访问。最终提交得到 30 分,包括六道题中的四道满分,超过 29 分的官方金牌线。关于 IMO 项目的训练方法和评估设计,英伟达团队还发布了《An Open Recipe for IMO Gold》论文。
“测试时计算”改变了成绩的含义
这项工作的一个重要信息,是微调与测试时计算之间存在相互作用。
在 IOI 项目中,GenCorrect 把微调带来的能力提升转化为多轮反馈中的更大收益;在 IMO 项目中,同时使用 SFT 和 RL 专业模型,比单纯从一个模型检查点生成更多样本更有价值。换句话说,专业化模型不仅能生成更好的候选答案,也可能提供更好的批评和修正能力。
这也使得不同模型成绩之间的简单比较变得更加困难。一个分数可能同时反映基础模型能力、训练数据、后训练方法、推理预算、提交次数、验证器和整个评测协议,而不只是模型的一次性回答能力。AIFlux此前在关于评测结果可复现性的报道中也指出,提示词、推理参数、评测环境和提交规则等信息,会直接影响一个基准分数的可解释性。
英伟达团队将其结论概括为:金牌线成绩来自模型专业化和透明推理工作流的组合,而不是微调或暴力采样中的任何单一因素。
开放模型、数据和推理配方
团队表示,相关模型、数据集和运行配方已经在 Hugging Face 上陆续开放。用于竞争性编程的 Nemotron-3-Ultra-CC 模型已经可以获取;IMO 项目的检查点、训练数据和 Nemotron-IMO-Bench 则被整理到Nemotron Labs IMO 2026 集合中。这个新基准包含 200 道奥林匹克数学级别的题目,以及报告中使用的 30 道开发集题目。
英伟达还在 NeMo-Skills 开源仓库中提供 IMO 推理流程、提示词、提交的证明和快速开始材料。对于 IOI,团队也公开了评估与推理管线以及 GenCorrect 方法。
这些开放材料的意义不只在于让外部开发者运行模型,也在于让外界更具体地检查金牌线成绩是如何产生的。不过,开放代码、检查点和数据并不等于低成本复现实验。5500 亿参数级别的 Ultra 模型仍然需要大规模计算和存储资源,竞赛期间的提交限制、模型运行环境和完整资源配置也会影响结果。
从“模型会解题”到“系统能完成任务”
IOI 与 IMO 的结果显示,前沿模型的能力评估正在从一次性问答转向更复杂的系统级任务:模型需要提出候选方案,利用反馈发现错误,再在固定预算内决定是否继续尝试。
这类成绩因此既是模型能力的信号,也是训练数据、验证器和推理编排能力的信号。对于研究者和使用者来说,最需要关注的并不只是 535.4 分或 30 分这些最终数字,还包括模型是否接受过特定领域训练、推理阶段使用了多少计算、是否允许多轮提交,以及官方评测和非官方实验之间的边界。
在这些条件被完整披露并由外部研究者进一步复核之前,更稳妥的表述是:Nemotron 团队展示了同一模型家族经过专业化和生成—验证—修正流程后,在 IOI 和 IMO 两类高难度竞赛任务上达到金牌线的结果;这为开放模型如何构建领域专家系统提供了一个可供检验的案例,但不应简单等同于模型在正式竞赛中获得了官方金牌。