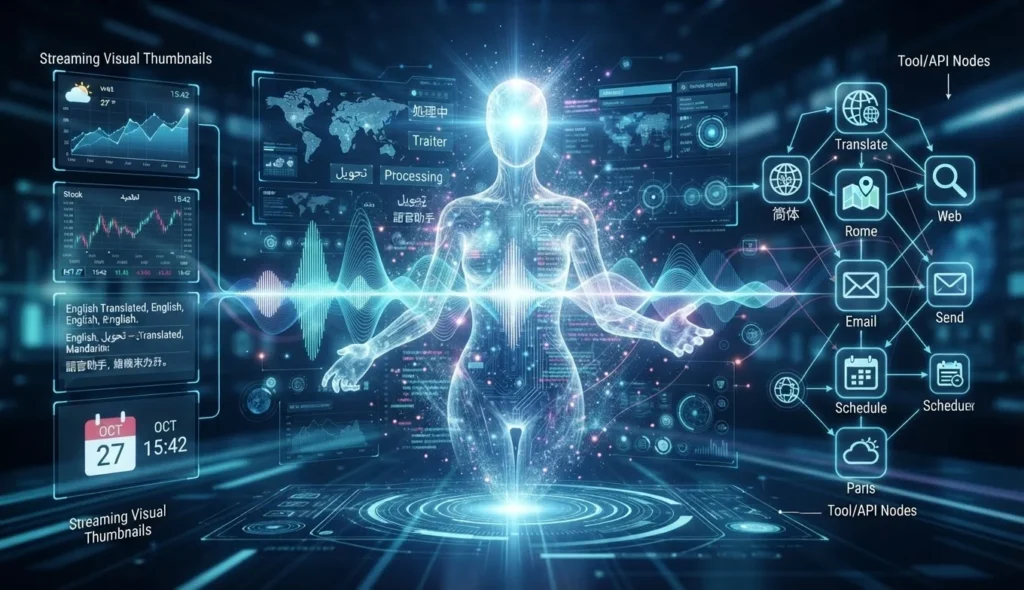
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking,目标将实时语音、视觉输入、工具调用与持续推理整合进单一交互链路,面向开发者、企业与普通用户分层开放,强化边聊边完成复杂任务的能力。新模型在多项语音与智能体基准中表现突出,并引入后台并行工具调用、实时视觉理解与多语言支持,但实际部署仍需关注权限、准确率与可靠性问题。
谷歌 9 月 15 日发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时对话模型,试图把语音 AI 从“即时回答问题”推进到“边聊边完成复杂任务”。新模型面向开发者、企业和普通用户开放的范围并不相同,其中部分服务仍处于预览阶段。
在 官方公告 中,谷歌将 Gemini 3.8 Live 定位为面向规模化部署和成本效率的模型,将 Gemini 3.8 Live Extended Thinking 定位为处理高复杂度任务、支持多步骤推理的版本。两者共同的变化,是把实时语音、视觉输入、工具调用和持续推理放进同一条交互链路。
两个版本,分别面向规模与复杂任务
谷歌称,Gemini 3.8 Live 结合了对话能力、流畅的实时交流和视觉理解,适合开发者及企业构建规模化语音代理。Gemini 3.8 Live Extended Thinking 则针对更复杂的工作流,能够在说话的同时进行更深入的推理。
这一区分延续了当前大模型产品常见的“双轨”设计:一类模型优先降低延迟和成本,用于高频交互;另一类模型允许消耗更多计算资源,以换取更强的规划和任务完成能力。对语音代理而言,这种差别尤其重要,因为用户通常不愿意等待模型完成全部思考后才得到回应,但复杂任务又不能只依赖快速的第一反应。
在谷歌披露的测试结果中,Gemini 3.8 Live Extended Thinking 在 Artificial Analysis 的 Speech to Speech Quality Index 中获得 82.6 分,排名第一;在 τ-Voice 智能体任务完成测试中达到 68.6%,在 Sierra 的 τ-Voice banking 测试中达到 35.1%,并在 Big Bench Audio 中获得 97.7%。谷歌还表示,Gemini 3.8 Live 在 Speech Agent Arena 中获得用户偏好排名第二。
这些数字首先是厂商公告中的结果,应结合测试设置、工具权限和评分方法理解。Artificial Analysis 的语音到语音模型排行榜将语音推理、对话动态和智能体表现分开衡量;其指数方法说明也显示,综合分数并不等同于单一的语音识别或语言模型能力。
实时视觉与后台工具调用成为核心能力
Gemini 3.8 Live 可以近实时处理视觉输入。谷歌展示的场景包括员工培训和实时下棋:模型根据摄像头或屏幕中的视觉信息理解当前情境,再以自然语言继续交流。
谷歌还称,该模型能够在对话过程中自动识别并切换 97 种支持的语言。这一能力对跨语言交流和全球化客服有直接意义,但语言数量并不等于每种语言都具备相同的识别准确率、语音自然度或工具调用可靠性。实际部署仍需要针对具体语言、口音和噪声环境进行测试。
另一个变化是,模型可以在继续说话的同时,在后台执行工具和 API 调用。它可以先回应“我来查一下”,让用户知道请求已经被接收,然后在任务进行过程中播报进度,而不必让整段对话停下来等待结果。
谷歌的Gemini Live API 文档将 Live API 描述为面向低延迟实时语音和视觉交互的开发接口,相关能力包括连续音频、图像和文本流处理。开发者可以通过工具调用和 Google Search 等能力,让语音代理获取外部信息或执行操作。
Extended Thinking 试图解决“边思考边交流”
对于复杂任务,Gemini 3.8 Live Extended Thinking 的设计重点是让推理和语音输出并行进行。谷歌称,模型可以使用“让我查一下”之类的早期语音提示确认已经理解请求,并在后台完成多步骤任务时持续说明进度。
官方展示的案例包括将草图转换为 React 组件、协调多个步骤的预订并执行异步函数调用,以及通过自然语言生成商业计划和营销工具包。在这些场景中,语音不再只是输入方式,而是贯穿任务规划、状态反馈和结果交付的界面。
这种交互方式可能减少用户面对长时间沉默时的不确定感,但也带来新的判断问题:模型何时只是表达正在思考,何时已经实际调用了外部工具;后台任务是否已经完成;以及用户能否在模型执行关键步骤前及时介入。对涉及预订、付款、发送信息或修改文件的操作,实时语音的自然感不能替代明确的授权和确认机制。
从 Gemini 应用扩展到 Workspace 与 Search
谷歌表示,新模型将逐步进入多个产品层级。Gemini 3.8 Live 面向开发者开放 Gemini API 和 Google AI Studio,面向企业在 Gemini Enterprise 中提供私有预览,并开始用于 Search Live。
Gemini 3.8 Live Extended Thinking 同样面向开发者开放 Gemini API 和 Google AI Studio;企业用户可在 Gemini Enterprise 中参与私有预览,面向 Gemini Enterprise for Customer Experience 和 Google Workspace 商业客户的支持则将陆续推出。普通用户可以在 Gemini Live 中使用,同时 Google AI Pro 和 Ultra 用户可在 Workspace 的 Docs 中使用,所有 Google AI 订阅用户则可在 Gmail 和 Keep 中使用相关能力。
这意味着“可用”并不是一个单一状态。开发者可以通过 API 试用模型,企业用户可能需要申请预览资格,普通用户能否使用则取决于产品、订阅、地区和推送阶段。谷歌公告并未把所有功能描述为普遍可用,因而不能将模型发布等同于所有地区、所有账号都已经获得完整能力。
语音代理的竞争从自然对话转向可靠执行
谷歌同时宣布与 Agora、Fishjam、LiveKit、Pipecat、Vercel 和 Vision Agents 等平台合作。这些平台负责实时媒体流基础设施,让开发者可以把更多精力放在语音界面和业务逻辑上。Salesforce、Genspark 和 Lumeris 也被列为对 Gemini 3.8 Live 系列感兴趣的合作方。
谷歌还表示,所有由其 AI 产品生成的音频都带有 SynthID 不可感知水印,以便识别由 Google AI 生成或编辑的语音。这个措施有助于内容溯源,但它并不能单独解决语音冒用、错误执行或用户误信的问题。语音代理进入客服、办公和个人信息管理场景后,身份验证、操作记录、权限隔离和人工复核仍是部署层面的必要条件。
从 Gemini 3.8 Live 的发布看,谷歌试图把实时对话模型从一个“更自然的说话者”变成一个能够持续推进工作的协作者。此前,AIFlux 已经报道过 Gemini Live 从语音对话走向任务执行,以及 谷歌 8 月 AI 发布中从 Gemini 3.7 Flash 到语音转写的产品路线。
接下来更关键的衡量标准,可能不再只是模型能否在演示中保持流畅,而是它能否在真实噪声、复杂权限、长时间任务和失败恢复中持续可靠地工作。对用户而言,真正的产品分水岭也将是:模型是否清楚说明自己正在读取什么、调用什么,以及哪些决定仍然需要人来确认。
来源: