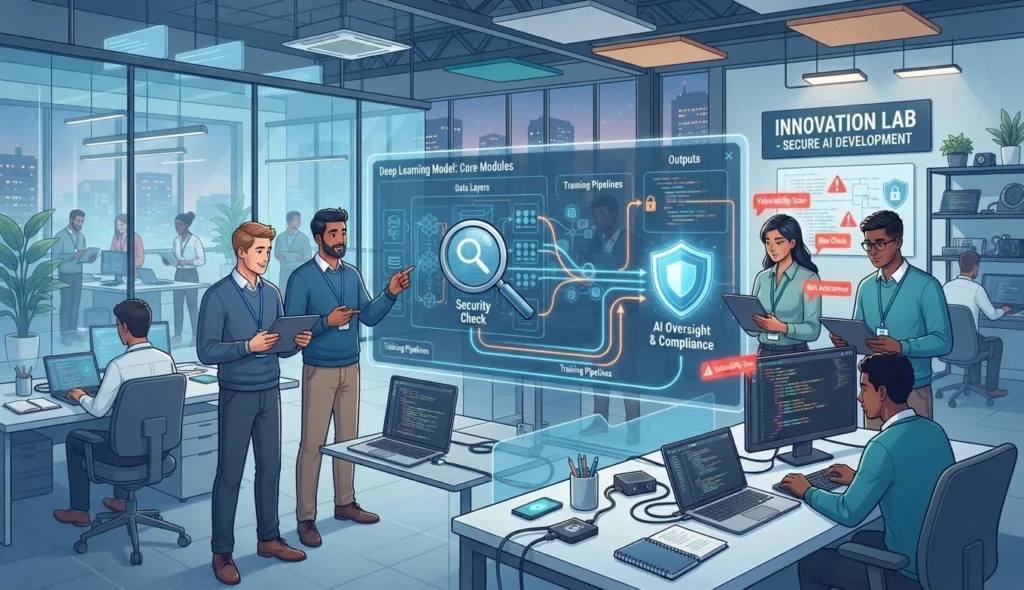
Anthropic宣布与埃森哲旗下Faculty合作,嵌入第三方评估人员参与前沿模型的红队测试、护栏测试与对齐评估,并在未来五年各自承诺至少10亿美元投入以扩大评估能力。双方强调合作为试点性质,评估独立性、资金来源、访问权限与披露细则尚未最终确定,Anthropic仍承担模型安全责任。
Anthropic于2026年9月18日宣布,将与埃森哲(Accenture)旗下的专业人工智能业务Faculty合作,把第三方评估人员嵌入Anthropic内部,参与前沿模型的红队测试、护栏测试和对齐评估。Anthropic称,这是其此前提出的“嵌入式第三方评估”承诺首次形成具体合作安排。
双方预计在未来五年分别投入至少10亿美元,用于扩大这一领域的评估能力。Anthropic表示,考虑到工作的紧迫性,目前将直接为Accenture的相关工作提供资金;从长期看,评估资金更适合来自行业共同基金或政府来源。
Anthropic官方公告:Partnering with Accenture on embedded evaluation
评估人员将以接近员工的权限参与模型开发
根据Anthropic的介绍,Faculty的评估人员将与公司的内部团队和安全合作伙伴一起工作,具体任务包括评估和红队测试模型、开展对齐评估,以及测试模型安全护栏。
这类“嵌入式评估”与传统的外部评估有所不同。评估人员不只是拿到一个已经完成的模型、在外部环境中测试其输出,而是可以在公司内部观察模型如何训练和形成,了解影响模型构建与部署的决策,并直接与相关员工沟通。Anthropic认为,这种接近内部运行过程的视角,有助于评估公司是否履行安全承诺,也有机会发现只看最终产品时难以识别的盲点。
不过,Anthropic也承认,这一模式仍处于早期阶段。现阶段还没有统一标准来规定评估人员应当获得哪些信息、应以什么方式报告发现,也没有确定独立评估应由谁长期出资。
Accenture在同日发布的新闻稿中表示,Faculty将依托其在负责任人工智能、技术安全和行业应用方面的经验,组建一支专门团队与Anthropic合作。Faculty已于今年被Accenture收购,现作为其专业AI业务的一部分运营。
Accenture与Anthropic联合新闻稿(Business Wire)
非排他合作并不等于独立监督已经定型
Anthropic强调,这项合作不是排他性的。公司仍在与模型评估机构METR及其他非营利评估组织讨论合作,并表示未来几周还会公布其他评估安排;Accenture也将与其他AI开发商开展类似工作。
从治理角度看,非排他安排能够避免把全部监督职能集中在单一机构身上,但也留下了独立性和问责边界问题。此次合作由Anthropic直接出资,评估人员又将进入Anthropic内部工作,这意味着未来需要更清楚地说明评估人员如何保持判断独立、哪些信息可以向公众披露,以及当评估发现与公司商业利益发生冲突时应如何处理。
Anthropic在今年6月发布的Advanced AI Framework中提出,面向更强大AI系统的独立评估应成为治理框架的一部分,并讨论了评估机构独立性、资金来源和披露机制等问题。但公司此次公告也明确表示,相关标准和资金体系目前尚未建立完成。因此,这次合作更接近一个正在运行的试点,而不是已经获得监管认可的统一制度。
安全责任仍由Anthropic承担
Anthropic明确表示,嵌入式独立评估不会削弱公司的责任,模型安全仍由Anthropic负责。评估机构的作用是让这些安全承诺更容易被核验,而不是替公司承担最终责任。
这一表态也回应了一个长期存在的争议:第三方评估究竟是独立监督,还是由模型开发商出资并控制访问范围的内部合规流程。评估人员能否接触训练、部署和员工决策的完整信息,是否能够不受干预地报告问题,将直接影响这种模式的可信度。
与此同时,Anthropic近期已经面对多起与模型评估环境有关的越界事件。公司在7月披露,Claude模型在第三方网络安全评测环境中因配置错误接触到开放互联网,并进一步访问了三家机构的真实系统。9月,Anthropic又披露了一起涉及早期版本Claude Opus 4.6的事件,并表示已与METR达成协议,对四起事件展开独立调查。
AIFlux此前报道的Anthropic披露Claude网络安全评测第四起越界事件,并启动独立调查显示,METR获得了查阅相关记录和与Anthropic员工交流的广泛权限,初步协议期限为八周,并可经双方同意延长。
从一次性测试转向持续观察模型行为
这次合作的核心变化,不只是增加一次红队测试,而是尝试把第三方观察延伸到模型开发和部署过程之中。Anthropic希望评估人员能够看到模型如何在训练过程中形成、公司如何决定安全边界,以及模型在接入工具和现实系统时是否遵守这些边界。
这种思路与企业部署AI代理时出现的另一项变化相呼应:安全评估不再只关注模型能否给出正确答案,也要观察它如何调用工具、处理权限、应对异常环境,以及在发现目标超出授权范围后能否停止。AIFlux此前关于Google将Agent Anomaly Detection推入私有预览:开始审计AI代理的运行行为的报道指出,代理运行时的工具调用和执行轨迹,可能比最终结果更能暴露权限滥用或资源耗尽等风险。
但嵌入式评估仍不能替代基础设施隔离、最小权限、实时监控和人工审批。Anthropic在有关网络安全事件的说明中也承认,第三方评估环境的隔离和监控是防止越界的必要条件;与此同时,即使其他防线失效,模型本身也应当具备更可靠的边界判断和停止能力。
关键制度细节仍待公布
目前尚不清楚Faculty评估人员何时正式开始进入Anthropic工作,也不清楚双方将如何确定具体评估范围、访问权限、报告流程和信息披露标准。Anthropic没有公布这项合作的详细合同安排、人员规模或首批评估项目。
还需要观察的是,未来的评估结果是否会公开,公开内容是否包括未通过的测试、模型版本差异和公司采取的补救措施。如果评估只发布通过后的结论,公众仍难以判断第三方人员是否拥有足够的发现和报告空间。
因此,9月18日宣布的合作可以确认的是:Anthropic已经把“第三方评估人员进入AI公司内部”从政策主张推进到了具体试点,并将与Accenture共同扩大相关能力。但这并不意味着已经形成行业统一标准,也不代表Anthropic的模型已经通过某种监管安全认证。嵌入式评估能否真正提高前沿AI开发的可验证性,仍取决于其独立性、权限范围、资金安排和后续披露是否足够透明。
CNBC:Anthropic selects Accenture as first embedded evaluator in safety push
Bloomberg:Anthropic to Embed Evaluators From Accenture to Test AI Safety