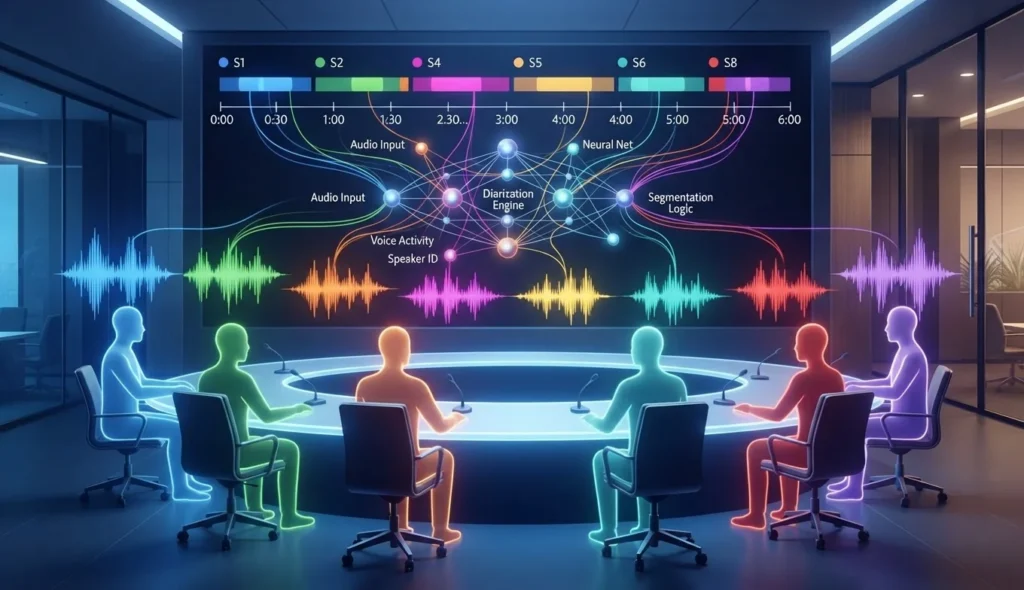
NVIDIA 推出开源权重的 Nemotron 3 Diarization 模型,支持最多八名说话者并能处理重叠语音,提供离线与流式两种 Sortformer 实现以实现实时说话者标签同步。模型在 Diarization 基准中表现领先,但属于 Early Access,带有评估许可限制,企业部署需注意延迟、标签稳定性与许可约束。
NVIDIA发布了一款面向多说话人场景的开放权重语音分离模型 Nemotron 3 Diarization。根据 NVIDIA 团队在 Hugging Face 发布的介绍,这款约 1 亿参数的模型支持最多八名说话者,能够处理重叠语音,并在实时流式对话与录音文件分析之间切换。
这项发布的重点并不只是把语音转成文字,而是为每一个时间片段标记说话者。对于会议记录、客服质检、播客编辑和语音代理来说,知道“说了什么”只是第一步;如果系统无法判断“是谁说的”,承诺、异议、打断和行动项就很难准确归属。
从“听见文字”到“知道说话者”
说话人分离(speaker diarization)通常被概括为“谁在什么时候说话”。NVIDIA 的 NeMo 文档将它与自动语音识别(ASR)区分开来:ASR负责识别内容,diarization负责把语音活动分配给不同的说话者。两者结合后,系统才可以生成带有“Speaker 1”“Speaker 2”等标签的转写稿。
Nemotron 3 Diarization采用端到端的 Sortformer 路线。与依赖语音活动检测、说话人嵌入提取和聚类的传统流水线不同,Sortformer可以直接从音频中预测说话者活动。NVIDIA的模型文档显示,NeMo同时提供离线 Sortformer 和 Streaming Sortformer;后者通过 Arrival-Order Speaker Cache,也就是按说话者首次出现顺序维护的缓存,在连续音频片段之间保持标签的一致性。
这对实时系统尤其重要。流式模型并不是等待整段录音结束后再处理,而是把音频切成相互重叠的小块,在新片段到来时更新已有的说话者状态。这样,会议字幕、语音机器人或通话分析系统可以在对话进行期间逐步得到说话者标签,而不必完全依赖事后批处理。
榜首成绩背后的几个数字
Hugging Face文章称,Nemotron 3 Diarization在 Voice Arena 初始 Diarization-Bench 结果中排名第一,Diarization Error Rate(DER)为14.72%。DER越低越好,它综合衡量漏检语音、把非语音误判为语音,以及把一名说话者误分给另一名说话者等错误。
NVIDIA方面还表示,与此前面向四名说话者的 Streaming Sortformer 基线相比,新模型将支持范围扩大到八名说话者,并在评测中实现平均约40%的相对DER下降;相关结果对应约1.04秒的延迟。文章同时指出,在说话者数量更多的条件下,改进幅度会进一步扩大。
这些数字仍应放在评测语境中理解。不同数据集对重叠语音、说话者数量、录音环境和延迟的处理方式不同,DER也会随着后处理参数、音频切块策略和硬件配置而变化。近期的跨模型说话人分离评测也显示,高说话者数量和重叠语音仍是现有系统最容易出错的场景。因此,排行榜上的单一名次不能替代目标业务中的实测。
“说话人分离”不等于“多说话人转写”
NVIDIA在介绍中专门区分了 diarization 和 speaker-attributed ASR。前者输出说话者活动的时间区间,后者还要把识别出的文字与说话者身份对应起来。一个系统可以相对准确地判断两个人何时说话,却仍然在嘈杂环境、快速轮换或多人同时讲话时把文字分配给错误的人。
这一区分决定了实际部署方式。开发者可以先用 Nemotron 3 Diarization 生成说话者时间戳,再与离线ASR结合;也可以把它接入流式ASR,在语音进入系统时同步生成带标签的内容。NVIDIA此前关于 Streaming Sortformer 的技术说明显示,这一路线已经被设计用于会议、联络中心、语音机器人和企业审计等场景。
对于语音代理而言,标签稳定性可能比一次性的识别分数更重要。代理需要知道当前发言来自客户、客服还是旁听者,也需要避免把多人对话中的指令混在一起。对会议摘要和行动项提取来说,错误的说话者归属可能比个别词语识别错误造成更直接的影响。
开放权重并不意味着立即可用于生产
Nemotron 3 Diarization的开放属性降低了研究和测试门槛,但目前 Hugging Face 模型页显示,该模型处于 Early Access 计划,并附带 NVIDIA 软件和模型评估许可。页面明确写明,模型及其衍生版本仅限内部测试和评估,不得用于生产,也不能在未经许可的情况下重新分发或披露评测结果。
这意味着“开放权重”与“可自由商用”不能画等号。企业在把模型接入客户通话、医疗录音或其他敏感音频前,还需要核对许可范围、数据处理责任、硬件要求和部署环境。模型页还显示,当前模型并未由 Hugging Face 的推理服务商直接部署,开发者需要依照 NVIDIA NeMo Speech 的路径自行准备环境。
下一步是从榜单走向真实对话
说话人分离正在成为语音系统的基础层能力。会议转写、客服分析、广播后期、语音记忆和多方语音代理,都不只需要更低的词错误率,还需要知道信息属于谁、发生在什么时候,以及多人重叠发言时哪些内容可以被可靠保留。
Nemotron 3 Diarization的意义,在于把更高的说话者数量上限、流式处理和开放模型生态放进同一套方案中。但它能否在真实部署中取代传统流水线,仍取决于语言覆盖、麦克风布局、噪声条件、重叠语音比例、显卡资源以及许可证限制。对开发者而言,下一步不是简单复述“排名第一”,而是用自己的会议、通话或语音代理数据,分别验证延迟、标签稳定性和说话者归属准确率。
来源: