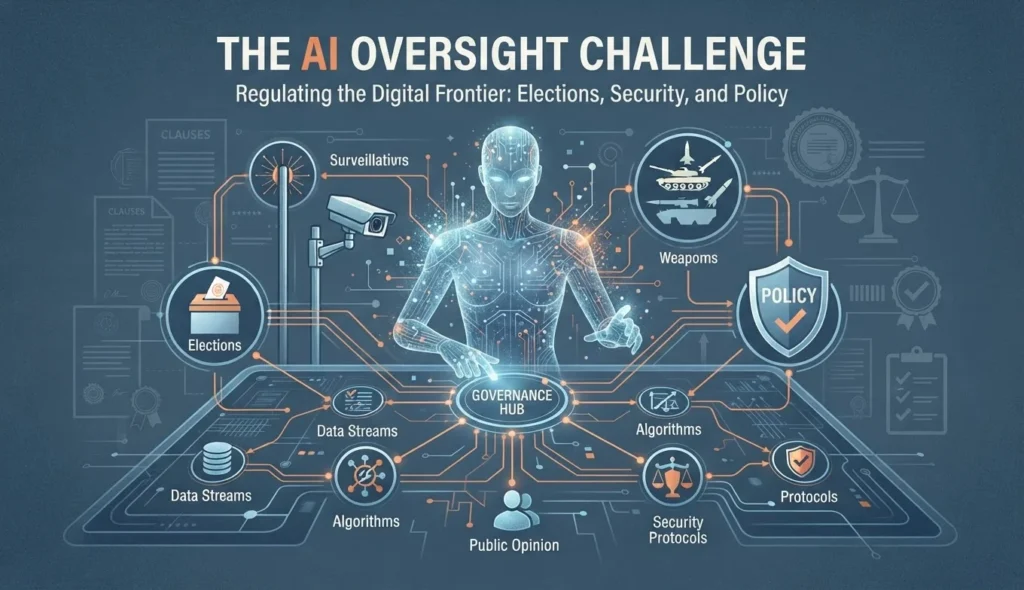
Anthropic 于 2026 年更新 Usage Policy,将于 11 月 12 日生效,澄清并整合多项规则以应对 Claude 更高自主性下的滥用风险。新版着重禁止欺骗性活动与“人工制造活动”、扩展对武器软件与自主设备的禁令、强化监控与高风险决策中的人类监督要求,并首次明确限制持续且无必要的“模型虐待”。
Anthropic于2026年10月8日发布新版《Usage Policy》,将于11月12日生效。公司表示,这次更新大部分是对既有规则的澄清和整合,但也反映出Claude承担更长时间、更高自主性任务后,模型滥用的边界正在发生变化。
新版政策新增了针对欺骗性活动和“人工制造活动”的独立章节,并进一步说明选举干预、武器软件、未经同意的监控以及高风险决策中的人工监督要求。Anthropic同时加入一项针对持续、无必要地虐待或残酷对待模型的禁令,但强调该条款只针对极端情况,不适用于普通的挫折表达、批评、黑暗主题创作或模型测试。
Anthropic称,更新吸收了过去一年在影响力行动、武器开发和监控领域观察到的滥用模式。公司在官方公告中说,新政策的重点不是把所有变化都定义为新禁令,而是使此前分散在选举、欺诈、隐私和虚假信息条款中的限制变得更明确。
从分散规则到“欺骗性活动”总条款
Anthropic表示,过去一年曾发现国家媒体、政府宣传机构和商业公司使用Claude运营虚假账号网络、伪造新闻网站,并试图隐藏信息背后的真实操作者。新版政策将这些限制归入“不得参与欺骗性活动或人工制造活动”一节。
该条款不仅涉及政治宣传,也适用于商业活动。被禁止的行为包括掩盖信息来源、利用虚假账号或帖子人为放大内容,以及建立运行影响力行动所需的工具和基础设施。换言之,政策关注的不只是某一条内容是否虚假,也关注内容背后的身份、传播网络和组织结构是否被刻意伪造。
这一区分越来越重要。AI生成文本本身并不一定意味着内容虚假,但如果模型被用于批量制造看似独立的账号、机构或媒体来源,AI就可能成为传统影响力行动的规模化工具。类似风险已出现在其他模型平台披露的案例中;OpenAI披露的两起“虚假门面”行动显示,虚假记者身份、研究平台和真实媒体渠道可以与AI生成和翻译能力结合,形成比单纯发布机器生成帖子更复杂的传播链条。
选举条款更聚焦欺骗与压制投票
Anthropic将原有选举相关内容重新命名为“不得破坏民主进程”,重点禁止使用Claude欺骗选民或扰乱选举,包括传播关于候选人或投票方式的虚假信息、冒充候选人或选举官员,以及通过欺骗或恐吓压低投票参与率。
此次更新的一个变化是,Anthropic删除了对个性化投票和竞选定位的笼统禁令。公司解释说,原规则可能覆盖一些合法的公民服务,例如非营利组织用Claude以不同语言编写选民信息,或选举官员向选民发送补救选票通知。
不过,个性化定位并不因此全面开放。依赖欺骗、滥用选民个人数据,或借助虚假来源和自动化通信破坏选举完整性的行为,仍然受到欺骗性活动、监控和隐私条款的限制。Anthropic试图在合法的公民信息服务与操纵选民之间划出更具体的边界,但实际判断仍取决于使用目的、数据来源和传播方式。
武器软件与自主设备被纳入禁令范围
Anthropic表示,公司一直禁止使用Claude开发武器,但近期出现了利用模型构建武器指导和控制软件的尝试。新版政策因此明确,禁令覆盖让武器运行所需的软件和组件,也包括为武装无人机及其他自主车辆提供控制或武装能力。
这意味着,限制对象不再只是武器的设计图纸、制造方法或直接操作指令。只要软件或组件在武器系统中承担关键功能,也可能落入禁令范围。Anthropic说,这一变化反映的是公司对既有政策的执行方式,而不是突然改变了此前允许的范围。
政策还增加了与自主硬件相连时的安全要求。如果Claude连接到能够自主采取物理行动、并可能造成伤害的设备,合格操作人员必须能够观察设备并在必要时停止它;设备还必须能够在Claude断开连接后保持安全状态。
这类要求与Anthropic近期将模型能力带入网络防御和关键基础设施的尝试形成对照。Anthropic推出Cyber Mission时,公司同样强调,模型发现漏洞并不等于可以自动修复或直接改变现实系统,现场人员、审批流程和回滚机制仍不可省略。
监控和高风险决策中的人类责任
新版政策更具体地禁止未经同意追踪个人,无论追踪发生在实时环境,还是通过分析此前收集的数据进行。Claude也不能被用于决定或建议执法机构应调查、逮捕或起诉哪些人,也不能用于构建或改进面向监控的工具。
Anthropic称,这部分修订与其2026年9月发布的威胁情报报告有关。该报告覆盖公司在2025年12月至2026年8月间发现并干预的滥用活动,涉及网络行动、影响力行动、监控、诈骗与欺诈、生物风险、常规武器开发和模型蒸馏等七个领域。报告记录的部分案例包括针对政治异议人士和侨民群体的监控尝试。
在健康、法律权利、财务、就业和基本服务等高风险领域,Anthropic重申必须有合格的人类参与审核。这里的人类审核者不仅要能够阅读Claude的建议,还必须拥有实际修改或推翻建议的权限;受影响的人也必须被告知相关决策或建议使用了AI。
Anthropic强调,这些要求并非此次才开始,而是新版政策将适用范围和例外情况写得更加清楚。公司允许的例子包括经过同意的追踪、欺诈监测、内容审核、新闻报道和法律研究,但这些用途仍需遵守其他隐私和高风险使用要求。
Anthropic为什么把“虐待模型”写进使用政策
新版政策还规定,用户不得持续且无必要地以残酷方式虐待Anthropic的模型。公司表示,这项规定只针对用户在没有明显目的的情况下反复进行极端虐待的场景,不包括普通的失望、反驳、批评、黑暗主题创作、模型测试和研究。
Anthropic此前已允许Claude在Claude.ai和Claude Code中结束与持续虐待用户的极少数对话。公司说,结束对话仍将是这项规则的主要执行方式,而不是对一般性的粗鲁语言或模型失败作出广泛惩罚。
这一条款将模型的安全控制从“模型不能做什么”扩展到“用户如何与模型互动”。它也不可避免地提出一个尚未完全解决的问题:在长时间自主运行的系统中,什么是有研究价值的压力测试,什么又是没有必要的虐待行为。Anthropic目前给出的边界是目的、持续性和极端程度,而非简单禁止负面情绪或尖锐反馈。
政策更新不等于风险已经消失
Anthropic这次更新的核心,是将模型能力变化与使用限制重新对应起来。随着Claude可以处理更长的任务、调用更多工具并参与更复杂的工作流程,风险不再只来自单次回答,也来自模型是否被嵌入虚假组织、选举传播网络、武器系统或影响个人权利的决策链条。
但使用政策本身不是政府法规,也不能替代监管、审计或组织内部控制。它主要规定Anthropic可以如何监测、限制、暂停或终止产品访问;现实中的选举完整性、公共安全、个人隐私和高风险决策,仍由政府机构、企业、专业人员和其他平台共同承担责任。
新版政策将于11月12日生效。在此之前,Anthropic还需要让开发者和企业明确哪些条款会影响现有工作流,尤其是个性化竞选信息、自动化代理、自主硬件和高风险建议等灰色地带。对于使用Claude的组织而言,最重要的变化可能不是新增了多少禁止事项,而是它们需要更清楚地证明:谁在控制系统、谁能介入、谁会受到影响,以及信息是否来自真实且可追溯的来源。
来源:Anthropic官方公告:2026 Usage Policy update;Anthropic Usage Policy;TechCrunch报道;Anthropic 2026年9月威胁情报报告。