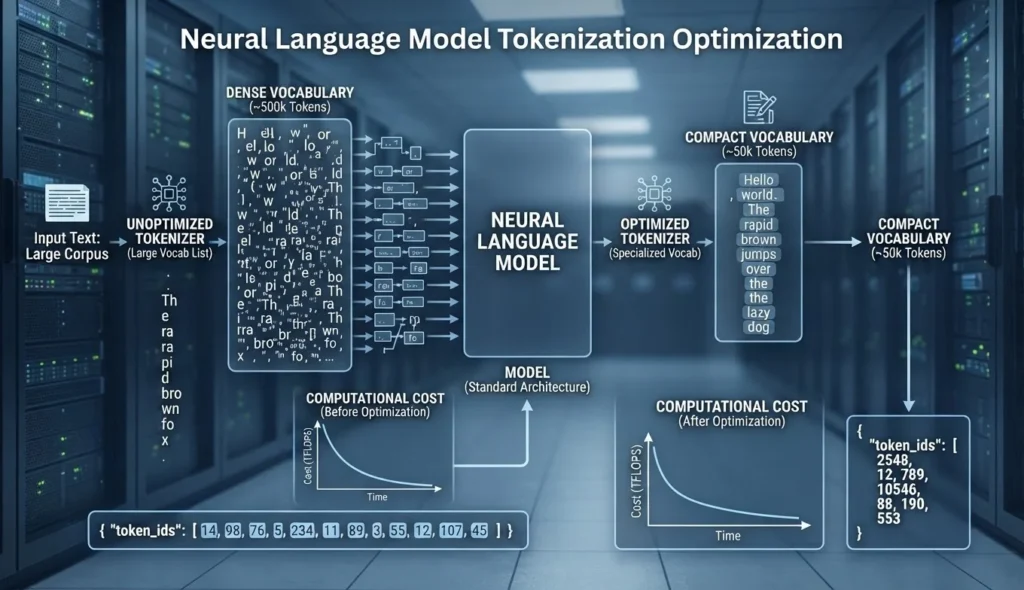
Hugging Face 社区团队 Dharma-AI 提出 VocabX,通过为小模型重建专用词表,在葡萄牙语作文评分系统里将实测推理成本降低了 77%,同时保持或提升评分质量。该方法通过合并多词片段与子词重构减少输出 token,并在多个领域与模型上展示了潜在优势,但结果仍需同行评审与独立复现。
Hugging Face 社区团队 Dharma-AI 公布了一项仍在准备中的研究结果:在一个用于葡萄牙语作文自动评分的生产系统中,通过重建小语言模型的词表,将实测推理成本降低了 77%。团队强调,实验没有更换基础模型、训练数据或训练方案,变化主要发生在模型使用的 tokenizer 和输出词表上。
这项工作于 2026 年 10 月 21 日发表在 Hugging Face 的团队文章中,标题为《How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications》。文章同时说明,完整的 VocabX 论文尚未正式发表,当前数字仍可能在同行评审和后续实验中调整。
通用词表给专用模型留下了两种浪费
Dharma-AI 的案例基于一个已经投入生产的葡萄牙语作文评分器。系统使用 Qwen3-4B,接收作文、题目和参考材料,并输出包含分数及各项能力评价的 JSON 结果。
Qwen3-4B 本身只有约 40 亿参数,但其原始词表是为多语言、多领域的通用文本建立的。团队在文章中称,模型每次生成时都需要面对约 151,669 个词表条目,其中许多与葡萄牙语作文评分和固定 JSON 输出格式几乎没有关系。
通用词表带来的第一个问题是“碎片化”:评分器反复生成的能力名称、评价措辞和 JSON 结构,可能被拆成多个 token。第二个问题是“过剩”:即使某些语言或符号在目标任务中几乎不会出现,模型仍需在生成每个 token 时为整个词表计算分数。
团队用 VocabX 将词表缩减到约 64,767 个条目,同时把反复出现的领域词语、短语、完整句子和 JSON 结构纳入新的词表设计。文章中的示例显示,同一句固定文本在基础 tokenizer 下需要 14 个 token,使用 VocabX 后只需要 4 个。
生成一个 token,通常比读取一个 token 更昂贵
这项研究的关键并不是简单地追求更少的 token,而是区分输入和输出 token 的成本。
在大模型推理中,prefill 阶段会一次处理完整输入,通常更接近计算受限;decode 阶段则一次生成一个 token,每一步都要重新读取模型权重和不断增长的 KV cache,因此更容易受到显存带宽限制。vLLM 对 prefill 和 decode 的工程解释也指出,decode 往往是内存带宽受限的工作负载,而不是单纯的算力问题。
在 Dharma-AI 的测量中,作文评分器生成一个 token 的成本约为读取一个 token 的 7.4 倍。不过,团队特别提醒,这一比例会随着硬件、批大小、上下文长度和任务类型变化,不能直接当作所有部署环境的固定常数。
这意味着,针对模型输出进行压缩,可能比同等幅度地压缩输入带来更大的实际收益。VocabX 因此按照 token 出现在系统提示、用户输入还是模型响应中,对候选词项进行加权,而不是只依据它们在语料中的出现频率。
VocabX 同时处理子词和多词片段
Dharma-AI 表示,过去的词表适配方法往往集中在一个层面:要么改变单词如何被拆分,要么把常见的多词表达合并起来。VocabX 试图同时处理这两类问题。
在子词层面,它重新构建领域词汇的切分方式;在多词层面,它会寻找从短表达式、完整句子到带有标点的 JSON 结构等重复片段,并将它们作为所谓的 macro token 纳入词表。团队使用五类自动化“挖掘器”寻找不同类型的重复内容,包括长词、整行、表达式、完整句子以及 JSON 和标签结构。
文章称,在八个语料库的平均结果中,带有标点和结构信息的挖掘器贡献最大;在代码语料中,这一部分单独贡献了 17.5 个百分点的 token 缩减。如果移除这五类挖掘器,作文评分器的 token 缩减幅度将下降 55.6 个百分点。
研究还试图解决抽样评估的遗漏问题。某个候选片段可能在完整语料中出现很多次,却没有出现在用于评估的少量样本中。团队没有把这类候选直接视为“没有收益”,而是使用基于可观测候选行为的统计估计。文章称,在合同语料上,这一改动在相同样本和词表预算下,将 token 缩减率从 44.7%提高到 52.8%。
生产评分器的输出从 350 个 token 降至 101 个
为了测量实际效果,Dharma-AI 训练了七个版本的评分器,保持基础模型、数据、训练方案和随机种子不变,只改变 tokenizer。所有版本在同一台配备 RTX 5090 的机器上,通过 vLLM 推理服务器处理相同的 500 个测试请求,并根据实测运行时间计算成本。
结果显示,评分器平均输出长度从 350 个 token 降至 101 个 token,实测推理成本下降 77.0%。与此同时,团队使用一个综合评分来衡量评分准确率,以及过滤离题或违反规则作文的能力;该分数从 0.703 上升到 0.810。
研究过程中也出现了一个重要的反例。VocabX 的早期版本把每项能力的分数与周围 JSON 结构合并成一个 macro token,虽然输出更紧凑,但综合分数从生产版本的 0.703 降至 0.689。后来团队让分数拥有独立 token,只增加每次响应约两个 token,综合分数升至 0.810;在该测量中,这一版本的成本降幅反而达到 77.0%,高于融合版本的 73.3%。
这说明,压缩并非越激进越好。如果被压缩的片段同时承载了模型需要作出的判断,节省 token 可能会损害任务质量。更合理的目标,是在保留决定性信息的前提下减少重复结构的生成成本。
五个领域和三类模型中的结果仍应视为团队报告
为了检验结果是否只适用于作文评分,团队还在合同、医学论文、科学论文、新闻和 Python 代码五个公开领域,以及 Qwen3、Llama-3.1 和 Gemma-3 三个模型家族上,将 VocabX 与快速词表迁移、多词 tokenization 和 Liquid AI 的 in-place BPE 等方法进行比较。
Dharma-AI 称,在 15 个组合中,VocabX 的压缩效果都超过最强的对比方法,优势范围为 1.2 至 9.3 个百分点。在估算推理成本方面,裁剪版 VocabX 也在全部 15 个组合中领先;相对优势在 Qwen3、Llama-3.1 和 Gemma-3 上的平均值分别为 10.2、7.5 和 13.6 个百分点。
这些数字目前仍主要来自论文作者团队自己的实验。文章没有提供一篇已经公开、经过同行评审的 VocabX 论文,也没有说明独立团队在其他硬件、服务编排和真实流量条件下复现了 77% 的降本结果。因此,更稳妥的表述是:VocabX 展示了一个有潜力的成本优化方向,而不是已经被普遍验证的通用降本比例。
词表可能成为小模型部署的新成本杠杆
基础模型的词表长期以来常被视为不可变的继承属性。已有研究已经探索了如何通过词表迁移或多词 tokenization 减少序列长度,例如 Fast Vocabulary Transfer 和 Multi-word Tokenization for Sequence Compression。Liquid AI 的 In-Place Tokenizer Expansion for Pre-trained LLMs 则从另一个方向研究如何在保留预训练模型的情况下扩展 tokenizer。
VocabX 的不同之处在于,它试图把 token 出现的位置、生成阶段的成本以及词表规模放进同一个优化问题,并同时处理子词和多词片段。它也把问题放在小模型和专用任务的生产环境中:当输入输出格式高度固定、模型批量较小、生成成本占比较高时,词表设计可能比通用模型场景更直接地影响服务账单。
但这条路线仍有现实限制。改变 tokenizer 需要确认训练和推理阶段产生完全一致的 tokenization,还要处理词表映射、模型权重中的输入与输出矩阵、特殊 token,以及与推理框架和下游工具的兼容性。Hugging Face 最近对 Tokenizers v1 候选版的工程优化也说明,tokenization 本身正在重新成为推理系统端到端性能的一部分,而不只是模型接收输入前的轻量步骤。
对 AI 服务商而言,这意味着成本优化可能不再只围绕量化、批处理、KV cache 或硬件采购展开;对于领域明确、输出格式固定的小模型,词表本身也可能成为值得测量和调优的系统组件。下一步的关键,则是 VocabX 论文能否公开完整方法和实验表格,以及独立测试能否确认它在不同语言、模型架构和服务负载中的收益边界。
来源:
- Hugging Face / Dharma-AI:How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications
- Qwen/Qwen3-4B 模型页面
- vLLM:Inside vLLM: Anatomy of a High-Throughput LLM Inference System
- Fast Vocabulary Transfer for Language Model Compression
- Multi-word Tokenization for Sequence Compression
- In-Place Tokenizer Expansion for Pre-trained LLMs