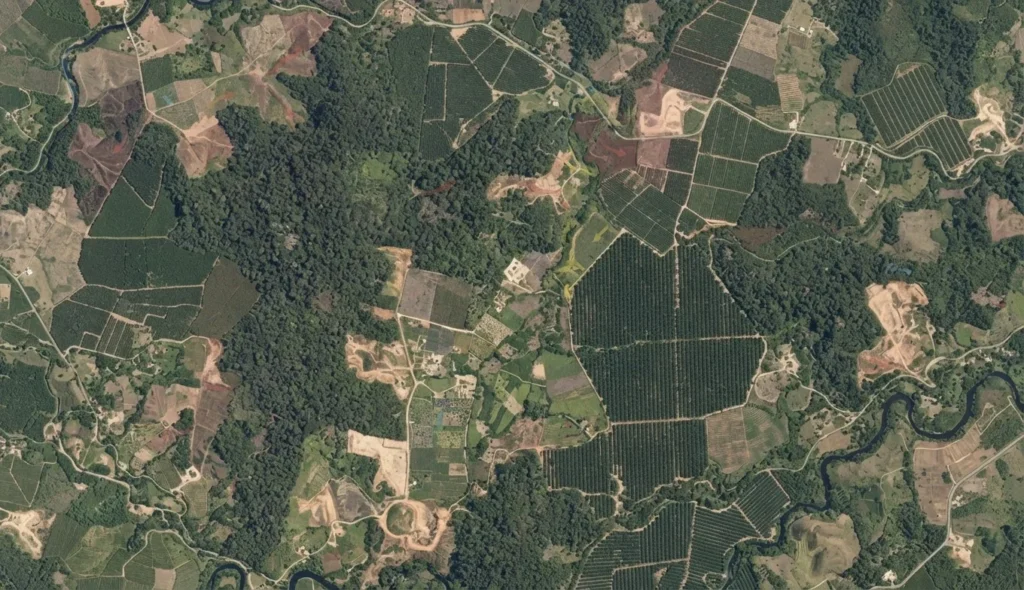
Google DeepMind 与 Google Research 联合发布 ForTy 森林分类地图,基于 10 米像元将土地分为六类并提供 2017–2025 年的年度变化序列,旨在区分天然林、自然再生林与各类人工种植林,提升对森林转换类型的识别能力,但研究团队与 Google 均强调数据并不能替代实地核查或直接用于法律认定与供应链合规证明。
Google DeepMind与Google Research于2026年10月22日联合世界资源研究所(WRI)、国际应用系统分析研究所(IIASA),公布ForTy 2020森林分类地图,并分享覆盖2017至2025年的早期年度变化序列。它试图回答一个传统树木覆盖图难以解释的问题:一片土地重新变绿,究竟意味着天然林恢复,还是原有森林被木材种植园、油棕园等取代?
根据Google DeepMind的公告,ForTy以10米像元区分六类森林及土地利用类型,并通过年度序列追踪这些类型之间的变化。对森林保护和商品供应链调查而言,这比单纯统计树木是否存在更接近实际需要。但它仍是一套遥感分类数据,不是自动认定商品合规、判断毁林责任或替代现场调查的系统。
为什么“有树”不等于“森林得到保护”
从卫星上看,原始森林、桉树种植园和油棕园都可能呈现大片绿色;它们的碳储量、生物多样性与土地用途却不相同。天然林被砍伐后重新种上经济树种,树冠覆盖可能恢复,原有生态系统却未必恢复。只看覆盖面积,就可能把这两种变化混为一谈。
这也是ForTy希望补足的监测缺口。它将土地分为原始林、自然再生林、人工种植林、集约经营种植林、树木作物与农林复合系统,以及其他土地。前四类属于其森林分类;油棕、橡胶、果树等以非木材商品为主要产出的种植系统归入农业用途,而不是因为长着树就被视为森林。
其中,Planted Forest与Plantation Forest需要特别区分。前者指通过种植或播种建立、轮伐周期较长的人工林;后者侧重树种较少、树龄相近、排列规则的集约经营林。研究为两者设置了40年的操作性轮伐周期分界,但承认这只是经营强度的代理指标,并非联合国粮农组织或欧盟法规统一规定的硬性年限,也不能适用于所有地区的林业实践。
这并不是Google首次尝试区分天然林与其他树木覆盖。其2025年11月发布的Natural Forests of the World 2020主要回答某地在2020年是否为天然林。ForTy进一步细分森林及农业树木类型,并加入跨年度变化信息。官方目录已经引用2026年5月的预印本,因此本次进展应理解为新的正式公告及年度序列公开,而非这项研究第一次出现。
AI如何从卫星记录中推断土地用途
ForTy的关键输入是AlphaEarth Foundations嵌入,即将多来源、多时相卫星观测压缩成每个地表位置的特征表示。它们不是现成的森林标签,而是供下游模型识别季节变化、空间纹理和土地利用模式的输入。
发表于Scientific Data的研究论文介绍,团队利用约170万个全球分布的样本,结合弱监督学习、主动学习和分阶段训练构建分类系统。不同来源的标注需要先协调定义;模型难以区分的地区,再通过专家反馈和定向补充标注改进。后续训练还利用相邻年份的信息,减少年度预测中的噪声。
难点在于,卫星直接观察的是地表覆盖,而森林类型往往取决于经营历史和土地用途。一片成熟的人工林可能在影像上接近自然再生林;刚采伐、等待补种的林地,则可能暂时没有明显树冠,却仍属于森林用途。因此,更多像素或更高空间分辨率,并不能消除所有分类歧义。
遥感嵌入正在成为可复用的数据层。此前本站关于OlmoEarth v1.3的报道介绍过另一种年度嵌入及其分析工具。两者的产品层级不同:通用嵌入提供可供下游任务使用的地表特征,ForTy则围绕明确的森林类型定义,把特征转化为专题分类结果;这不意味着两者的精度或适用范围可以直接比较。
90.2%的总体准确率,不能代表每一种森林
研究团队报告,ForTy在六类分类上的总体准确率为90.2%,森林与非森林二分类为95.5%,天然林与其他土地二分类为94.8%。这些是研究方开展验证后报告的结果,并非本报道独立运行模型所得。
验证最初抽取了9100个全球分层随机样点,由两名受训专家分别判读高分辨率影像和历史卫星记录,再通过讨论处理分歧。其中8190个样点形成共识,用于准确率估计;738个尚未完成共识处理,172个被标为不确定。论文指出,不确定或未解决样点更多集中于人工经营、过渡性类型,将它们排除在统计之外,可能使准确率估计存在一定偏差。
总体分数还受到类别面积分布影响。“其他土地”占较大的面积权重,且较容易识别,因此会显著拉高整体准确率。相比之下,人工种植林类别的F1分数只有58.2%;原始林为82.9%,自然再生林为72.6%,集约经营种植林为66.7%。F1综合衡量误判与漏判,不能与总体准确率混作同一指标。
这意味着,需要识别人工林的使用者,不能直接把90.2%当成自己任务的可靠性。不同洲、不同森林类型的表现也有差异,样本较少的地区与类别组合尤其需要谨慎。上述精度主要针对2020年基准图,不能未经验证就套用到2017至2025年的每一幅年度地图,更不能等同于土地类型转换识别的准确率。
年度序列增加了什么,又没有证明什么
2020年地图提供一个基准状态;年度序列则尝试说明,在此之前和之后,同一地点如何从一种类型转向另一种类型。按Google的介绍,它可以帮助辨认天然林转为木材种植林,以及弃耕土地逐渐自然恢复等过程。
对调查人员而言,这类结果能够缩小需要核查的范围:森林减少发生在哪里,之后出现了哪一类土地用途,是否值得进一步调取影像或当地记录。它不能仅凭分类标签证明变化的经营主体、法律责任或具体原因。年度档案也不是按天更新的毁林预警。
Google将2017至2025年序列明确称为早期发布,并表示未来数月会继续改进。因此,不能把这一序列描述成已经完成全面业务验证的成熟监管系统,也不能把2020这一数据基准年误当作本次发布年份。
从保护工具到供应链证据,中间仍有核查环节
ForTy的一项应用背景是欧盟零毁林产品法规(EUDR)。相关框架以2020年末为重要基准,区分森林转为农业用途的毁林,以及部分森林类型转换构成的退化。对于木材、咖啡、可可、油棕等商品,仅知道某处仍有树木,并不足以解释其土地利用历史。
欧盟委员会的法规说明要求相关经营者证明产品不涉及规定范围内的毁林或森林退化。森林分类图可以为尽职调查提供信息,但不能代替商品来源追溯及其他必要证据,也不意味着地图中的低风险标签自动获得监管认可。
公开数据本身也有明确边界。Earth Engine官方目录说明,2020年产品覆盖南纬65度至北纬84度之间的陆地区域,采用CC-BY 4.0许可,并非无地理边界地覆盖整个地球。10米指输出像元尺度;目录同时提醒,输入数据的有效分辨率可能更粗,小农地块和混合像元会降低分类精度。
对于荫蔽咖啡、可可等混合农林系统,模型仍可能将其误认作天然林;道路或居民点附近的原始林边缘也可能被归为自然再生林。采伐后等待重新种植的林地可能被误分为其他土地,“其他林地”则未单独成类,而是并入其他土地。
此外,各类输出分值未经事后概率校准,应理解为相对置信分数,而不能直接把某个高分解释为同等比例的真实正确概率。若要用于量化风险评估,使用者仍需结合独立的地区参考数据开展验证,必要时重新校准。
ForTy的价值,在于让森林监测从“绿色面积是否减少”走向“哪一种森林正在被什么取代”。但分类更细,也把遥感无法直接观察的经营历史、混合用途与制度定义带入了模型。能否成为可靠的保护与供应链工具,最终取决于使用者是否保留这些限制,并把地图与原始影像、当地记录和必要的实地核查结合起来。