LightOn 发布 SlideOn 与 mSlideOn,两款将神经语义表示输出为高维稀疏向量以接入倒排索引的检索模型,展示了在保留语义匹配的同时可调稀疏度带来的效率-质量权衡,但公开基准与代理指标并不足以直接推断生产环境的延迟或成本节省。模型与训练代码已以 Apache-2.0 授权公开,复现与端到端部署仍需在各自语料和索引实现中进一步验证。
LightOn在2026年10月19日发布技术公告,介绍英语稀疏检索模型SlideOn和多语言模型mSlideOn。两者要解决的不是如何生成更流畅的回答,而是搜索系统如何在理解语义的同时,减少查询时需要访问的数据。
据团队技术博客,SlideOn拥有174M参数,mSlideOn拥有339M参数,分别从DenseOn和mLateOn转换而来。两款模型均支持最长8192 tokens的输入,并输出可用于倒排索引的稀疏向量。它们提供了一条连接神经网络语义表示与倒排索引的路径,但团队公布的基准并不支持“全面替代稠密或多向量检索”的结论。
为什么语义搜索又回到倒排索引
稠密检索通常把一段文本压缩为一个向量,通过向量相似度寻找相关内容。后期交互(late interaction)模型则保留token级表示,在评分时进行更细粒度的匹配。这能保留更多局部信息,却也增加了索引存储和评分的工程负担。此前本站关于Sentence Transformers 6.0引入多向量检索接口的报道,讨论的正是这类质量与成本之间的取舍。
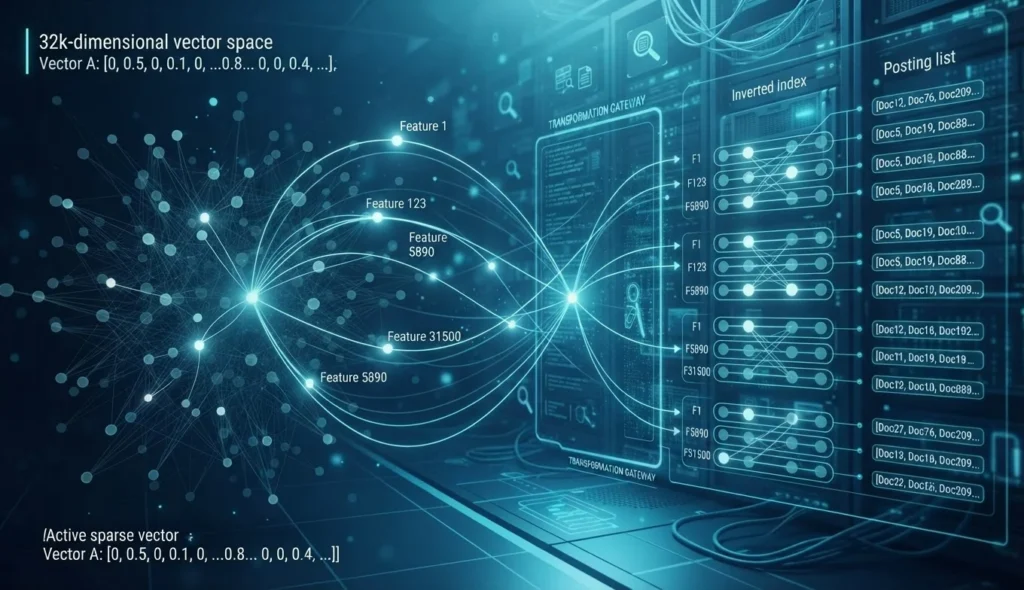
SlideOn系列采取另一种表示方式:查询和文档都被转换成32768维的非负向量,但大多数维度为零,只保留少量激活特征。倒排索引为每个特征记录哪些文档激活了它;查询时,只需遍历对应的文档列表,没有共享激活特征的文档可以跳过。
这里的特征并不直接等同于分词器词表中的词语,而是模型学习到的潜在特征。因此,这不是退回单纯的关键词匹配,也不能把每个维度直接解读成人类可读的概念标签。其目标是在保留语义匹配能力的同时,让检索能够利用倒排索引。
从已有模型转换,而非从头学习检索
LightOn先训练稀疏自编码器(SAE),将已有模型的token表示重构为稀疏特征,再进行有监督的检索微调。微调阶段移除重构用的解码器,联合训练骨干模型与稀疏编码器,最终通过跨token的最大池化,为每个查询或文档生成一个向量,以点积计算相关性。
这一流程复用了DenseOn和mLateOn已学到的检索知识。团队使用的多语言微调混合数据约含1630万组查询与正样本文档,涵盖九种自然语言及代码,并采用交叉编码器提供的相关性分数进行蒸馏。英语模型只选择其中的英语部分。
两款模型还采用Matryoshka式训练,使信息更多集中在权重较高的特征中。开发者可以在推理时分别设置查询和文档保留多少个激活特征,不必为每个预算重新训练模型。查询剪枝减少需要访问的倒排列表,文档剪枝则缩短列表,并减少需要存储的权重。
需要区分两个层级:编码时每个token选择最高的32个潜在特征,不代表整篇文档最后只有32个非零值;文档级剪枝是在池化后另行执行,也不会改变32768维的输出空间。
基准显示收益,也显示转换的损失
SlideOn模型卡报告,在不剪枝的设置下,其BEIR-15平均nDCG@10为56.68,DenseOn为56.20,LateOn为57.22。这说明它在该英语检索基准上超过了起点稠密模型,但仍低于后期交互模型。nDCG@10衡量前十条结果的相关性及排序质量,这些数值按0至100的尺度报告,并不是回答正确率。
可调稀疏度是另一项重要结果。模型卡列出的查询最多保留64个特征、文档最多保留512个特征的配置,BEIR-15得分为56.66,retrieval FLOPS代理指标为8.72;不剪枝配置对应的指标为30.87。这个例子显示,在团队测试中,剪枝可以在较少损失排序质量的情况下减少特征重叠带来的评分工作量,但不能据此直接推算延迟加速倍数。
mSlideOn模型卡则显示,不同任务的取舍更加明显。其完整MIRACL多语言基准得分为62.78,完整MLDR长文档基准为61.68,均高于mDenseOn的58.02和51.50;然而,mLateOn在这两项上分别达到67.04和77.92,仍然领先。
代码检索是mSlideOn较突出的部分:在MTEB Code上得分74.78,高于mDenseOn的71.53和mLateOn的73.48。反过来,其英语BEIR-15得分为56.00,低于上述两个多语言模型。这些结果更适合被理解为检索架构之间的任务取舍,而不是单一模型在所有场景中获胜。
语言覆盖也必须看清口径。完整MIRACL结果覆盖18种语言,完整MLDR覆盖13种;模型卡另列的“目标语言”成绩只计算检索训练数据覆盖的相应语言,不能与完整基准混用。对中文应用而言,多语言总分也不足以证明在特定中文语料、专业术语和长文档上的表现,仍需单独测试。
效率代理指标不等于生产账单
上述成绩均来自LightOn公布的材料,并非本报道独立运行的复测。团队对稀疏模型采用完整评估语料上的精确点积搜索,以减少近似检索和候选生成设置造成的差异。这有助于比较表示质量,却不能替代真实搜索引擎的端到端测试。
模型卡明确说明,retrieval FLOPS估计的是查询与文档共享激活特征的数量,是搜索成本代理,不是实测延迟,也不是编码器的浮点运算量。效率测量使用SciFact、NFCorpus和FiQA中的固定样本,共6000篇文档和1271条查询。文档非零特征数同样只是存储成本代理,不等于索引实际占用的字节数。
因此,企业不能仅凭这些图表判断CPU、GPU或云资源账单会下降多少。实际评估还需要覆盖文本编码、索引构建与更新、并发查询、尾部延迟,以及特征在业务语料中的分布。更少的非零值提供了优化空间,但最终收益仍取决于索引实现和工作负载。
开放权重之后,复现与部署仍有边界
两款模型卡均标注Apache-2.0许可证,团队也公开了SAE检查点及训练与评估仓库。这为自托管和继续研究提供了入口,但公开代码不等于发布成绩已经被完整复现。
仓库明确提示,检索微调所需的数据混合与过滤仍由上游流程负责,部分历史数据集修订版本不可获得,发布指标的完整复现尚未确立。这一限制应与模型成绩一起看待,而不能因为脚本已经公开就忽略。
对企业搜索、检索增强生成(RAG)和代码搜索团队而言,SlideOn系列的实际价值,是增加了一种可测试、可调节稀疏预算的召回方案。选择它的依据不应是“稀疏一定更便宜”,而应是在自己的数据与索引系统中,能否用可接受的排序损失换来足够明确的存储、延迟或维护收益。