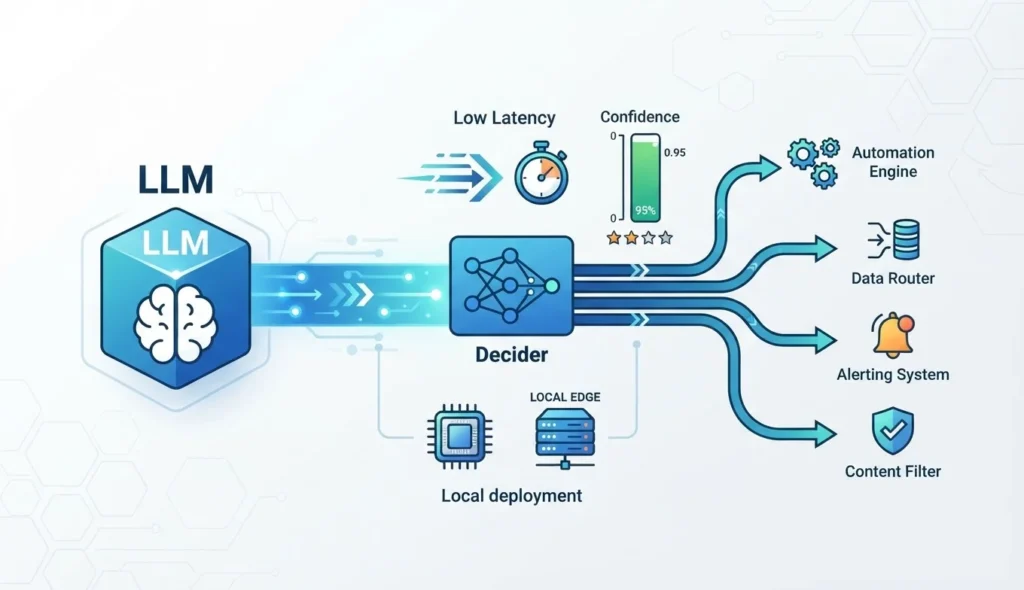
AWS旗下Strands Labs开源了Strands Decider 2B,一款用于智能体工作流的轻量级决策模型,专注于在预定义选项中快速打分和选择以降低延迟和成本。官方公布了准确率、校准与延迟评测数据,并提供代码与权重,强调该模型适合本地快速试验但不替代通用大语言模型用于生成或复杂推理。
AWS旗下Strands Labs于2026年10月1日发布并开源Strands Decider 2B,一款面向智能体工作流的轻量级决策模型。它不负责生成长篇回答,而是从预先定义的选项中作出选择、给出分数,并提供相应的置信度。
这类模型试图解决智能体系统中的一个具体问题:当程序需要判断“该调用哪个工具”“这条请求应该交给哪个模型”或“下一步是否应该继续执行”时,是否有必要每次都调用一个能够写长文本的通用大语言模型。
Strands Labs表示,Decider 2B适合快速实验和本地开发,可运行在本地CPU或GPU上。官方测试显示,它在常见硬件上的本地决策延迟为数十到数百毫秒,具体结果取决于任务规模和设备配置。
它不是一个用于聊天的通用模型
Strands Decider 2B的设计与传统语言模型不同。官方介绍称,开发团队以Qwen3.5-2B预训练模型为基础,移除了负责生成语言的LM head,换成一个用于给候选答案评分的pointer head。
模型接收一段状态信息、一个问题和一组选项,然后直接对这些选项进行比较。例如,系统可以要求它判断某条请求是否属于账单问题,或者在“账单、销售、零售”等团队中选择一个负责部门。它也可以对一个判断给出介于0和1之间的数值分数。
这一架构牺牲了输出的灵活性,但换来了更受限、更容易被软件直接使用的结果。模型不会突然输出一个不在候选集合中的答案,也不需要开发者再从自然语言中解析意图。
不过,Strands官方也明确指出,这种模型并不适合代码生成、聊天、文件摘要或复杂问题求解。它的优势在于有限选项中的快速判断,而不是替代通用前沿模型。
从语言模型“回答问题”到为软件“决定下一步”
Strands Labs把Decider 2B归入一类正在出现的“决策模型”或“System One模型”。这类模型的共同点是:它们不把主要目标放在生成文本上,而是让模型输出能够直接进入程序控制流的结构化决定。
在智能体工作流中,这种能力可能被用于模型路由、工具选择、评测、护栏、记忆管理、上下文管理和策略分类。一个更复杂的智能体仍然可以交给通用大语言模型完成推理和文本生成,同时把较为重复、边界清晰的判断交给轻量决策模型。
例如,一个智能体准备调用天气工具时,Decider 2B可以先检查工具参数是否来自用户已经提供的事实,并判断当前是否应该先向用户追问地点。只有在检查通过后,工具调用才会继续执行。Strands的示例代码把这一结果转换为Proceed、Deny、Confirm或Guide等操作。
这种分工与近期AI系统中出现的“控制层”思路相似。Cloudflare此前发布的开源决策模型Clef与Clef-flash也采用了相近的方向:让模型返回概率化的结构化判断,再由外围软件决定是否自动执行、转交人工或拒绝请求。
官方评测关注准确率、校准和延迟
Strands Labs表示,决策模型的评估重点主要包括三个方面:准确率、校准能力和延迟。
准确率衡量模型是否选出了正确答案;校准能力则关注模型给出的置信度是否可靠。例如,一个模型若经常以很高置信度作出错误判断,可能比明确表示不确定更加危险。延迟则决定它是否适合放在智能体的高频路径中。
根据Strands官方博客,Decider 2B在JevBench公开测试集的准确率和校准表现位于同规模模型前列:在包含33个模型的2B参数级别中排名第三;如果排除略高于2B参数的模型,则在30个模型中排名第一。官方还表示,该模型在JevBench的简单任务上取得了100%的正确率。
GitHub仓库给出的结果记录显示,在JevBench v1公开集合的231项任务中,相关版本取得了0.723的准确率,即231项中答对167项;JevBench Brier分数为0.342,预期校准误差为0.052。仓库同时提醒,公开任务数量有限,少于约10项的单次运行差异不应被视为已经确定的优势。
在延迟方面,Strands博客称,使用本地Nvidia RTX 3090测试时,模型的中位延迟约为115毫秒,95分位延迟为299毫秒;在苹果M3 MacBook上,小型任务的中位延迟约为153毫秒。任务越大,处理时间大致呈线性增加。
这些数据来自项目团队披露的硬件和评测设置,不能直接等同于所有部署环境下的性能保证。输入长度、候选选项数量、设备、推理框架和外围工作流都会影响实际结果。
为什么选择2B参数规模
Strands Labs给出的理由主要有两点。
第一,较小的模型更适合开发者在现有硬件上快速尝试,训练和部署的成本也相对可控。第二,团队认为2B参数可能在实验门槛和实际能力之间形成一个平衡:规模足够小,便于本地运行;规模又足够大,可以处理智能体系统中一部分有明确边界的判断。
项目目前提供了命令行工具。开发者可以通过pip install strands-decider安装,再传入状态信息和候选选项,让模型输出选择结果及其分数。官方也提供了将模型嵌入Strands智能体的示例代码。
项目代码、训练数据清单、训练脚本和评测资料均已放在Strands Decider GitHub仓库,模型权重则发布在Hugging Face模型页面。仓库和模型采用Apache 2.0许可证。
开源决策模型的价值取决于边界设计
轻量决策模型的吸引力在于,它可以把一些高频判断从昂贵的通用模型调用中分离出来,并且更容易在本地运行。对于需要反复执行路由、分类或工具准入检查的系统,这可能同时降低延迟和推理成本。
但模型本身不会自动解决智能体的安全和可靠性问题。候选选项如何设计、任务边界如何定义、置信度阈值设在哪里,以及低置信度结果是否转交人工,都会直接影响系统表现。
一个只在固定测试集上表现良好的决策器,未必能适应真实业务中不断变化的输入。特别是在权限控制、付款、数据删除或外部系统写入等高风险动作前,开发者仍需要配合最小权限、审计记录、人工确认和回滚机制。把模型的高置信度当作绝对正确,也可能放大错误决定的影响。
Strands官方并没有把Decider 2B描述为通用前沿模型。更准确的理解是,它是一个可以放在大模型和软件控制流之间的专用组件:让通用模型处理复杂推理和语言表达,让小型决策模型处理部分可枚举、可验证、需要快速响应的判断。
随着AWS、Cloudflare以及其他公司相继进入这一领域,竞争的重点可能不只是模型参数规模,而是决策模型能否在真实智能体工作流中稳定地提供可校准、可审计、可部署的判断。对开发者而言,开源权重降低了试用门槛,但最终效果仍需要用自身任务、候选选项和部署环境进行验证。