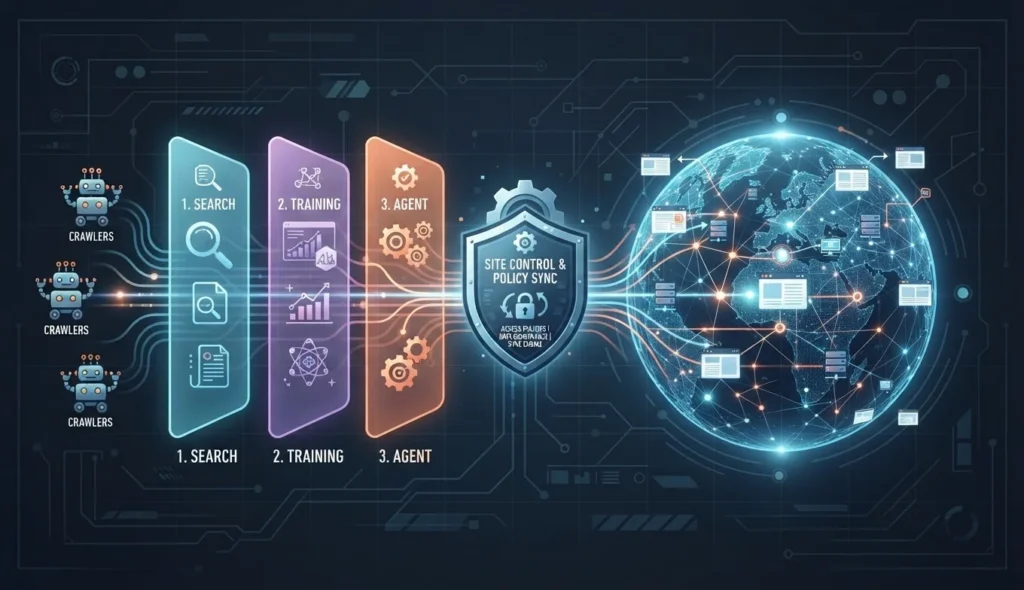
Cloudflare于2026年推出“Disallow AI Training”设置,将搜索、训练和代理三类爬虫访问拆分,允许网站在拒绝用于AI训练的同时保留搜索曝光。新方案通过Bot Preference Sync在robots.txt与边缘网络层同步偏好,并引入“Accountable”爬虫认定以区分可继续进行搜索抓取的混合用途爬虫。
Cloudflare于2026年9月15日宣布推出“Disallow AI Training(禁止AI训练)”设置,试图解决网站长期面临的两难:如果拒绝内容被用于人工智能模型训练,是否也会因此失去传统搜索引擎带来的曝光。
这项设置允许网站继续接受符合条件的混合用途爬虫进行搜索索引,同时阻止其他训练爬虫访问内容。Cloudflare还推出“Accountable(负责任)”爬虫 designation,并把搜索、训练和代理访问拆分为三个独立的控制类别。
不过,这仍然是Cloudflare提出并执行的平台控制与行业承诺框架,并不等于整个互联网已经完成统一实施。Apple、Google和Microsoft的支持情况及时间表,也以Cloudflare披露的内容为准。
从“一刀切”转向搜索、训练和代理三种控制
过去,网站运营者往往只有一个简单选择:允许自动化爬虫访问,或者整体阻止AI机器人。问题在于,一些大型平台使用同一个爬虫同时完成搜索索引和AI训练。网站如果阻止这个爬虫,可能会同时失去搜索可见性和训练数据控制权。
Cloudflare称,在其网络上,混合用途爬虫占已验证爬虫流量的36.6%,是最大的单一类别。与此同时,少于1%的网站选择阻止搜索爬虫,而约17%的网站采取了某种限制AI训练的机制。这些数据是Cloudflare基于自身网络观察得出的统计,并非整个互联网的普查结果。
新的控制分为三类:
- Search(搜索):抓取内容并建立搜索索引;
- Training(训练):抓取内容用于训练或微调模型;
- Agent(代理):代表用户实时访问页面,例如聊天获取机器人或浏览器操作代理。
在新的设置下,网站可以选择“Allow(允许)”“Block on pages with ads(阻止带广告页面)”或“Block(全面阻止)”。对于训练用途,新增的“Disallow AI Training”意味着网站表达“不用于AI训练”的偏好,但不必因此阻止所有搜索抓取。
Bot Preference Sync如何工作
Cloudflare同时将原有的“Managed Robots.txt”替换为“Bot Preference Sync”。网站管理员在Cloudflare控制面板中设置搜索、训练和代理偏好后,系统会把相应规则同步到robots.txt,并在边缘网络上执行相应的阻断规则。
Cloudflare表示,若网站启用“Disallow AI Training”,系统会在robots.txt中发布适用的“不训练”偏好。对于被Cloudflare认定为符合透明度要求的混合用途爬虫,该信号可以允许其继续为搜索索引抓取;其他训练爬虫则会被阻止。
这意味着robots.txt本身并不是唯一的执行机制。它更像是网站向爬虫表达意愿的标准化信号,而Cloudflare的网络层控制则用于阻止不遵守偏好的爬虫。
对已有网站,Cloudflare称多数情况下不需要立即采取行动,现有设置会迁移到新的控制体系。对新接入、依靠广告收入的网站,推荐配置是允许搜索、禁止训练,并在带广告页面阻止代理访问;不依靠广告变现的网站则默认允许三类访问,网站所有者可以自行修改。
“Accountable” designation意味着什么
Cloudflare为被列入“Accountable”的爬虫运营方设定了四项要求:
- 通过robots.txt或类似标准,为网站提供退出AI训练的方式;
- 为网站提供退出AI生成摘要的方式;
- 提供URL级别的可见性,让网站了解哪些页面被用于搜索或训练;
- 公开确认,退出训练不会影响传统搜索排名。
Cloudflare表示,Apple、Google和Microsoft已经满足这些条件,或承诺在规定时间内完成相关能力建设。Applebot、Bingbot和Googlebot等混合用途爬虫,在网站选择“Disallow AI Training”时可以继续进行搜索抓取;如果网站选择“Block”,这些爬虫则会被整体阻止,搜索曝光也会受到影响。
对于Amazon、Anthropic、Meta和OpenAI,Cloudflare称其相关搜索与训练爬虫可以被区分,因此网站可以单独阻断训练用途,而不影响传统搜索。这里的“Accountable”是Cloudflare根据其标准作出的分类,不代表这些公司已经接受一套由全行业统一执行的监管规则。
争议从训练授权延伸到AI摘要
Cloudflare此次公布的重点是训练控制,但公司也把AI摘要列为下一阶段问题。训练与摘要并不是同一件事:前者涉及内容是否进入模型开发过程,后者涉及用户是否在搜索或AI产品内直接获得答案,从而减少访问原网站的必要。
Cloudflare称,目前符合“Accountable”条件的运营方必须提供摘要退出方式,但网站通常需要分别在各个平台设置。公司目标是在2027年初左右,让网站所有者通过Cloudflare统一控制内容在摘要中出现的比例。不过,这一时间表属于Cloudflare的目标,而不是已经完成的功能。
Google在2026年8月31日公布的网站控制更新中也表示,正在测试让网站通过Search Console管理内容是否出现在AI Overviews、AI Mode等生成式搜索功能中,并提供页面出现情况和展示次数等数据。Google同时强调,退出这些生成式搜索功能会失去相应的流量和展示,但不会成为传统搜索结果之外的排名信号。
这显示出行业正在把问题拆成几个不同层面:内容能否被发现、能否被用于训练、能否被AI摘要引用,以及AI代理能否代表用户访问网站。对网站运营者而言,这些用途的商业价值和风险并不相同。
网站拥有控制权,但仍缺少统一的验证机制
Cloudflare的方案解决了一个实际问题:网站不必再通过全面封锁搜索爬虫,来表达拒绝AI训练的意愿。但它能否长期有效,仍取决于爬虫运营方是否准确识别身份、遵守robots.txt偏好,并提供足够的使用记录。
类似的内容授权争议已经出现在其他平台。AIFlux此前报道过Twitch默认允许Amazon使用主播内容训练生成式AI、主播可手动退出,其中一个核心争议就是“可以退出”与“能够证明内容没有被训练使用”之间的差距。
Cloudflare也承认,robots.txt无法单独阻止不合作的爬虫。公司正在参与互联网工程任务组(IETF)围绕“ai-prefs”等开放标准的讨论,希望未来形成更具可移植性的AI访问偏好表达方式。
因此,9月15日的变化更像是一次基础设施层面的重新分工,而不是训练数据版权争议的终点。接下来需要观察的包括:各家爬虫是否真正落实承诺、网站能否获得可核验的URL级使用记录、AI摘要退出是否会扩展到细粒度控制,以及不同平台之间是否会形成可互操作的标准。
来源: Cloudflare官方博客:Have it both ways: stay discoverable in search while disallowing AI training;Cloudflare新闻稿:Cloudflare Helps End the Search-or-AI-Training Tradeoff;Cloudflare:Say it once: introducing Bot Preference Sync。