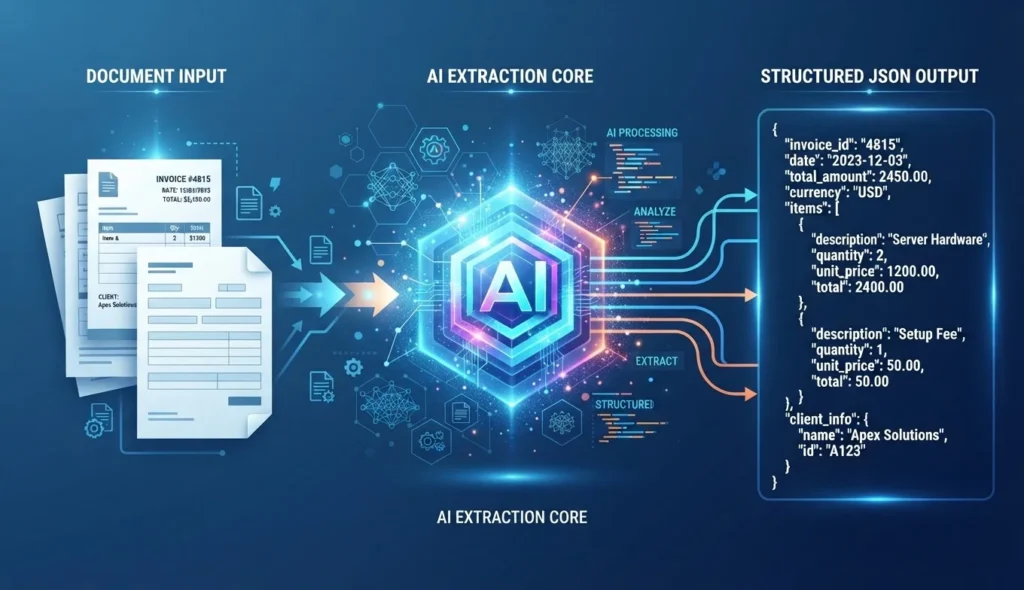
Dharma-AI 发布了 20 亿参数的文档字段抽取模型 Dharma Field Extractor,直接将发票、表单等图像映射为业务所需的 JSON 字段,支持指定 schema 和开放抽取两种模式。团队在自测评测中得分 0.834、并宣称运行成本低于通用 API,但结果受限于自测方法、中文覆盖和实际部署条件,需以客户自有数据与成本核算为准。
Dharma-AI 于2026年11月4日公布了文档字段抽取模型 Dharma Field Extractor。这款20亿参数模型不以完整转录页面为主要目标,而是尝试把发票、表单、身份证件等文档图像中的信息,直接转换成下游系统需要的 JSON 字段。
在发布于 Hugging Face 社区的团队文章中,开发方称,该模型在自建评测中的综合得分为0.834,高于其测试的四种通用前沿模型配置,同时具有较低的单次抽取运行成本。不过,这些结果来自 Dharma-AI 自测,不能视为 Hugging Face 的独立评估,也不足以证明它在所有文档、语言和部署环境中都优于通用模型。
这次发布所针对的问题很具体:企业需要的往往不是一页文字,而是能进入数据库和业务流程的几个数值、名称或日期。
从“把字读出来”到“把字段填进去”
一张供应商发票经过 OCR,即光学字符识别,可以得到页面上的文字;但如果财务系统只需要供应商、发票编号、到期日和总金额,识别之后仍要完成字段定位、语义对应和格式转换。表格中的每一项商品,还需要保持行与行之间的对应关系。
Dharma Field Extractor 将这一步作为专门任务。按照开发方的说明,它支持两种模式:不提供预设结构时,模型根据上下文和版面寻找可抽取的键值对;提供 schema,即输出结构定义时,则按指定字段名及字符串、数字、布尔值等类型生成结果,支持嵌套结构和表格行项目。
例如,业务系统可以要求输出 service_provider 与 client_company,而不是再把模型自行生成的字段名映射到数据库列。团队称,如果文档没有所要求的信息,模型应返回 null,而不是补出一个值;指定 schema 时,也应保留相同键名、不增加额外字段。
这些是产品的预期行为,而非零错误保证。JSON 可以被程序解析,与字段内容准确无误,是两项不同要求。对于金额、身份信息或医疗预约资料,结构合规并不能代替内容核对。
20亿参数模型怎样训练
团队介绍,新模型以 DharmaOCR-LITE v1.1 为基础。这是一个20亿参数版本,此前已接受面向 OCR 的监督微调和直接偏好优化(DPO);开发方又在该检查点上,使用43,384条训练样本训练了一个低秩适配(LoRA)适配器,覆盖开放抽取与指定结构抽取两种请求。
训练材料包括公开网络收集的英语多领域文档、内部取得的真实巴西葡萄牙语文档,以及占比较小的其他欧洲和亚洲语言文档。文档类型涉及收据、商业发票、表单、银行账单、身份证件和合成文档。团队称,同一模型检查点可以处理这些类型,无需为每一类文档分别微调。
这一技术路线延续了该团队此前的 OCR 专精研究,但不是把旧模型换一个名字。其2026年4月15日提交的 DharmaOCR 预印本讨论的是70亿参数 Full 和30亿参数 Lite 模型,重点包括转录质量、生成稳定性和推理成本。论文将重复循环输出视为会拖慢推理、增加计算开销的工程故障,并通过偏好优化加以抑制。
AI Flux 此前对DharmaOCR 专精路线的报道也围绕这一背景展开。本次新增的核心,是从页面转录转向按业务字段抽取;旧版 OCR 的成绩不能直接当作新任务的成绩。
0.834分意味着什么
Dharma-AI 为此次字段抽取设计的评测包含546份文档。每份文档对应三类请求:不提供 schema 的全字段抽取、只包含真实字段的部分 schema,以及混入故意不存在字段的 schema,共计1,638个测试用例。
这一设置不仅考察模型能否找到信息,也考察它在被要求填写不存在的字段时,是否会编造答案。
评分不是简单的“准确率”。开发方使用字段级 F1,并按字段路径匹配,其中包括字段在表格中的位置;随后再乘以匹配值的 Levenshtein 字符串相似度,以及输出为有效 JSON 的比例。因此,0.834是特定公式下的综合分,不能改写为“83.4%的文档完全正确”。
团队报告,Dharma Field Extractor 得分0.834,Claude Opus 5 为0.816,GPT-5.6 Luna 为0.741。其结论应限定为:在这套评测和所选配置中,新模型的综合分领先,而不是小模型已全面超越前沿模型。
测试配置也影响比较。开发方称,通用模型的推理设置均为低档,Claude Opus 5 使用可在简单页面上跳过推理的自适应 effort。不同提示、推理预算或客户文档分布是否改变结果,仍需要另行评估。
团队还展示了来自 SROIE 收据和 FUNSD 表单的两个抽取示例,并称这两个数据集未用于训练。作为背景,FUNSD 项目官网将其定义为面向噪声扫描文档理解的数据集,包含199份完整标注表单,涉及文字、语义实体及关系。这有助于解释为什么字段抽取不仅是识字,也涉及版面和信息关系理解;但个别成功示例不能代替完整测试集上的错误分析。
对于中文业务,公告只说明训练材料含有少量其他亚洲语言文档,并未给出单独的中文成绩。不能据此认定模型已经适用于中文发票、病历或证件。
“成本相差6至147倍”并非完整部署账单
成本是公告中另一个醒目的结论。开发方称,在其测试口径下,被比较的通用 API 单次抽取成本,约为该自托管模型 GPU 运行成本的6至147倍。
两边的核算方式并不相同:API 一侧依据实测的每页平均输入、输出 token 数,包含推理 token,再按服务商公开标价计算;Field Extractor 一侧则按单张 NVIDIA L40S 的 GPU 使用时间计算,采用每小时2.24美元的价格。
开发方明确指出,这不是产品销售价格,自托管成本还取决于硬件、处理量和延迟要求。对于采购者,这更适合被理解为一项计算资源成本比较,而非已经兑现的总成本节约。运维、系统集成、人工复核,以及低利用率时的资源闲置,仍需纳入实际部署评估。
同样,能在自有基础设施运行,也不自动意味着可以免费下载权重或不受限制地商用。现有 Dharma-OCR-LITE 模型卡描述的是旧版30亿参数 OCR 模型,并明确声明其模型制品不是 OSI 开源,采用受限制的非商业许可,企业内部业务使用等用途需要另行书面授权。不能把这个旧仓库的下载链接当作新字段抽取模型已经开放权重的依据,更不能把旧版许可直接套用于新品。
Dharma Field Extractor 的实际看点,是把“读出文档”之后仍然存在的字段整理工作纳入专门训练。如果它在客户自己的文档上保持准确性,并在目标吞吐量下保有成本优势,就可能减少从图像到业务数据之间的转换环节。是否值得替换现有流程,最终仍取决于真实字段错误率、异常处理能力、部署成本与授权条件,而不是参数规模或一张排行榜。