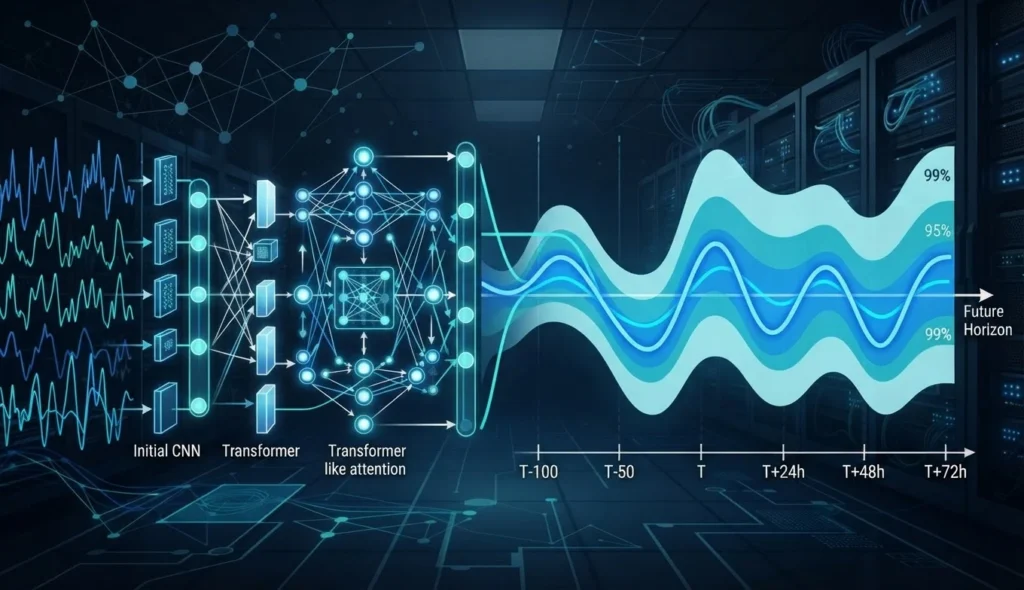
IBM发布Granite Time Series PatchTST-FM-r2,一款约3.85亿参数、支持8192步上下文和99个分位点概率预测的时间序列基础模型,采用Apache 2.0与OpenMDW 1.0双重许可并开放权重与代码。相比r1,r2引入Conformer模块、重叠分片、合成数据与训练改进,在GIFT-Eval零样本可复现模型中排名靠前,但其最终评测状态和实际生产表现仍需进一步验证。
IBM研究团队发布了Granite Time Series PatchTST-FM-r2,一款面向零样本时间序列预测的基础模型。模型约含3.85亿个参数,支持最长8192个时间点的上下文、灵活的预测长度,以及覆盖99个分位点的概率预测输出。IBM同时开放模型权重、架构、推理流程和复现实验所需代码,并采用Apache 2.0与OpenMDW 1.0双重许可,使用者可以选择其中一种许可使用。
这使PatchTST-FM-r2成为近期时间序列基础模型竞争中一个值得关注的案例:它没有把重点放在更大的参数规模上,而是试图通过架构调整、训练数据扩展和更严格的零样本评测,在企业常见的需求预测、能源负荷、交通、价格和设备遥测等任务上取得较稳定的泛化能力。
从PatchTST-FM-r1到r2,变化不只是扩大模型
PatchTST-FM-r2延续了PatchTST系列的基本思路,即把连续时间序列切分为较短的片段,再将这些片段作为类似“词元”的输入处理。原始PatchTST论文将分片和通道独立作为核心设计,使Transformer能够在更长历史窗口上工作,同时减少多变量序列之间的相互干扰。原始PatchTST论文
r2版本则用Conformer模块替换了原来的普通Transformer模块。每个模块在多头自注意力之后加入卷积层,并在两个“半步”前馈网络之间组织这一结构。IBM的解释是,卷积层更适合捕捉相邻片段之间的短期变化,而自注意力则可以继续关注较长时间范围内的关系。
模型还采用了大小为16、步长为8的重叠分片,并在训练时使用Hamming窗口对损失进行加权,在推理阶段通过overlap-and-add方式组合预测结果。网络模块数量从r1的20个增加到30个,同时加入预输出层归一化,以改善训练稳定性。训练阶段还引入了由CauKer方法生成的合成数据。
根据模型卡,r2的隐藏维度为1024,分片长度为16,预测头覆盖从0.01到0.99的99个分位点,模型上下文长度为8192。概率预测意味着模型不只给出一个单点答案,也可以输出不同置信水平下的预测区间,帮助使用者处理库存、安全产能或能源调度中的不确定性。
GIFT-Eval排名靠前,但结果仍需区分评测状态
IBM模型卡显示,截至2026年8月31日,PatchTST-FM-r2在GIFT-Eval中,按CRPS和MASE指标计算,在“可复现、零样本”模型范围内排名第二。GIFT-Eval是Salesforce AI Research提出的时间序列预测基准,覆盖从秒级到年度的不同频率,包含单变量和多变量任务,并分别记录训练数据泄漏与是否提供复现代码等信息。GIFT-Eval开源仓库
不过,模型卡也特别注明,PatchTST-FM-r2的结果当时仍处于提交至GIFT-Eval的待处理Pull Request中。因此,IBM给出的排名首先是按照特定筛选条件重现的结果,而不是已经完成所有官方审核流程后的最终排名。模型卡还指出,如果把预训练模型与零样本可复现模型一并纳入比较,r2在CRPS和MASE上的排名分别为第三和第四。
这一限定很重要。GIFT-Eval允许使用者查看不同模型类型,并单独排除存在测试数据泄漏的模型。对于零样本基础模型而言,较高排名说明模型在未针对具体数据集进行微调的情况下表现较强,但并不等于它在所有行业数据、预测周期或数据质量条件下都占优。实际部署仍需要检查缺失值、异常点、采样频率、协变量质量以及误报和漏报成本。
训练数据包括公开数据、合成序列和混合增强
IBM披露,PatchTST-FM-r2的训练数据由四部分组成:从GiftEvalPretrain中筛选出的数据集;基于KernelSynth并参考TiRex论文建议生成的合成数据及少量增强数据;采用与Chronos论文相近流程构建、但排除GIFT-Eval评测数据集的TSMixup数据;以及由CauKer方法在IBM内部生成的约50万条序列,每条序列长度为4096。
这种组合反映出时间序列基础模型与语言模型之间的一个差异:可供训练的高质量、跨行业、标注清晰的时间序列并不像文本那样容易集中获取。合成数据可以扩大模式覆盖范围,但它能否代表真实业务中的季节性、结构突变和异常行为,仍需要通过独立数据与长期运行验证。
IBM在此前的时间序列研究中,已经建立了包括PatchTST-FM、FlowState、TinyTimeMixer和TSPulse在内的模型组合,分别覆盖概率预测、点预测、高吞吐推理、异常检测和分类等任务。IBM Research对时间序列模型的介绍显示,IBM希望将这些模型用于制造业监控、IT事件检测和电网等企业场景,而不是把时间序列能力局限在单一的学术排行榜上。
商业许可降低了试用门槛,但部署责任仍在使用者
PatchTST-FM-r2的模型卡显示,权重采用OpenMDW 1.0与Apache 2.0双重许可。相较于仅限研究用途的模型,Apache 2.0为企业测试、二次开发和商业应用提供了更清晰的路径。不过,代码、模型权重、训练数据和第三方数据集的许可范围并不必然完全相同,企业仍需对具体部署场景进行法律和合规审查。
IBM提供的最小使用示例依赖granite-tsfm软件包。开发者可以从Hugging Face加载模型,将一段历史数据交给时间序列预测管道,并选择预测长度和需要的分位点。模型当前的实现和相关示例代码位于IBM Granite TSFM开源仓库。
对于生产系统而言,开放权重只是起点。企业还需要评估模型在自身数据上的误差分布、预测延迟、内存和计算成本,以及当分布发生变化时如何重新校准或回滚。预测区间看似比单点预测更完整,但如果分位点没有经过实际数据校准,也不能自动等同于可靠的风险边界。
时间序列基础模型正在转向更接近业务的场景
PatchTST-FM-r2发布之际,时间序列基础模型的竞争正从“能否进行零样本预测”转向“能否处理真实业务中的多变量关系、不确定性和实时数据”。AIFlux此前报道,IBM与Confluent已将Granite时间序列模型接入实时数据流,在Apache Flink中提供预测和异常检测能力。这类部署把模型放在传感器、支付活动或业务事件经过的地方,使预测结果可以直接触发告警、补货或维护流程,而不是等到批处理完成后才生成报告。
Google近期发布的TimesFM 3.0则将重点放在多变量时间序列和历史、未来协变量的联合建模上。两者的路线并不相同,但共同说明,企业真正关心的并不只是某条曲线的下一组数值,还包括其他变量如何影响结果,以及预测的不确定性是否足以支持决策。
对PatchTST-FM-r2而言,下一步关键问题将是其GIFT-Eval提交能否完成正式合并,以及模型在更多独立、未参与训练的数据集和生产环境中的表现。开放许可扩大了试验范围,但模型是否能够在库存、能源、制造和金融等不同场景中稳定创造价值,仍需要使用者进行现场验证。
来源: Hugging Face模型卡:Granite Time Series PatchTST-FM-r2、IBM Granite TSFM开源仓库、GIFT-Eval开源仓库、相关研究论文。