Mistral于2026年10月发布Timestral系列时间序列基础模型,包含5M、28M、123M和209M四种规模,面向工业传感器、能源、供应链和金融等场景,强调CPU推理效率与多变量、概率预测能力。公司称209M在多个公开基准上取得领先,但完整技术报告与独立复现尚未到位,企业部署需核对许可与实际场景表现。
Mistral于2026年10月15日发布Timestral,这是该公司首个时间序列基础模型系列。该系列包括5M、28M、123M和209M四种参数规模,面向工业传感器、供应链、能源、金融和运维等场景,支持多变量预测、概率预测,以及历史协变量和已知未来协变量。
Mistral称,最大的Timestral-209M在GIFT-Eval、TIME和fev-bench三个主要公开时间序列基准上,在预训练、零样本模型中取得领先结果。公司表示,209M模型以约为此前最佳模型三分之二的参数规模实现了这一表现。不过,这些数字目前主要来自Mistral发布的评测结果,完整技术报告尚未公布,相关结果也仍需要独立复现。
从单条序列预测转向多变量建模
时间序列数据广泛存在于企业系统中:工厂会持续记录设备的温度、压力和振动,能源企业需要预测负荷,零售商需要结合销量、客流和促销安排规划库存,金融机构则需要预测资金流、交易量和波动率。
传统的ARIMA和线性回归通常针对单条序列建立模型;部分深度学习模型虽然能够学习多条相关序列之间的非线性关系,却往往需要针对每个新数据集重新训练。Mistral对Timestral的定位,是通过大规模预训练让模型能够在没有针对性训练的情况下迁移到新的时间序列任务,即所谓零样本预测。
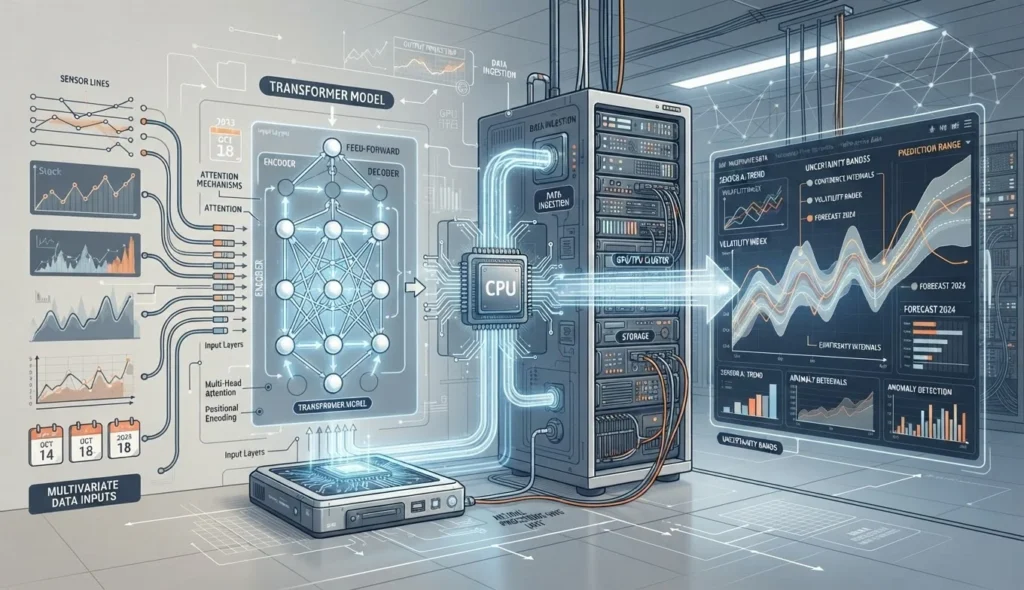
Timestral可以联合处理多个目标序列,也可以使用两类协变量:只在历史阶段可见的过去协变量,以及在预测区间内已经知道的未来协变量。后者可以包括生产计划、计划停机、节假日安排或天气预报等信息。它并不是“预知”未来,而是把用户已经掌握的未来安排纳入预测。
这一路线与此前时间序列基础模型的发展方向相呼应。AIFlux此前对Google Research发布TimesFM 3.0、原生处理多变量信息的报道也指出,预测模型正在从“预测一条曲线”转向利用跨序列关系和未来已知信息处理更接近业务实际的任务。
四种规模,重点强调CPU效率
Timestral四个版本采用相同的架构和训练方法。Mistral称,不同规模的模型分别位于准确率与模型大小之间的Pareto前沿:较大的模型通常带来更好的预测表现,较小的模型则运行更快、成本更低。
根据Mistral的示例,在配备8个线程的标准服务器CPU上,使用过去三周、每15分钟采样一次的数据预测未来一天,5M模型耗时约10毫秒,209M模型耗时约140毫秒。公司还表示,28M模型的速度约为209M模型的5倍,而123M模型的评测得分与209M模型相差不到0.2%,延迟约为后者的四分之三。
Hugging Face上的Timestral-209M模型卡显示,该模型支持最长32768个历史时间步,并可在一次前向计算中预测最多1024个时间步。模型输出21个分位数,而不是单一的点预测,因此使用者可以据此观察不确定性范围,并为库存、告警或维护计划设置不同的风险阈值。
模型卡还显示,Timestral-209M采用基于patch的Transformer架构,包含时间注意力和变量注意力,共24层,嵌入维度为768。推理可以运行在CPU或GPU上。Mistral在官方公告中则将其总结为一种可在本地部署、VPC或隔离环境中运行的时间序列基础模型。
基准领先仍需放在评测条件下理解
Mistral称,Timestral-209M在GIFT-Eval上的MASE为0.658、CRPS为0.446,在TIME上的MASE为0.626、CRPS为0.522;在fev-bench上,SQL skill score为50.39,MASE skill score为39.49。上述指标的方向并不相同:MASE和CRPS通常是越低越好,skill score则是越高越好。
这些结果说明Timestral在Mistral采用的公开测试设置中具有竞争力,但不等于它在所有行业数据上都必然优于现有模型。时间序列预测对数据清洗、缺失值处理、预测周期、协变量可获得性以及分布变化都很敏感。比如,生产计划如果频繁改变,或者天气、需求和设备状态数据存在延迟,模型在基准数据上的优势未必能够直接转化为现场收益。
Mistral表示,相关结果已经提交至GIFT-Eval和TIME排行榜,并将发布技术报告。因而,在完整报告公开、评测设置和数据处理流程得到更多说明之前,Timestral的“排名第一”应理解为厂商基于当前评测提交所作的表述,而不是已经完成独立审计的结论。
从模型到异常检测和根因分析
Mistral展示的一个工业工作流,是让Timestral持续处理工厂传感器数据,在异常出现时发出信号;随后由语言模型和智能体系统检索历史上相似的传感器模式,并结合维修记录、交接班日志、操作员备注、设备手册和过去工单进行根因分析,最后生成带有证据和后续建议的诊断报告。
这显示了时间序列模型与语言模型结合的一种可能路径:前者负责数值信号和不确定性预测,后者负责检索非结构化资料、组织证据和解释结果。但Mistral目前展示的是示例性工作流,并不意味着Timestral已经完成了大规模工业部署,也不意味着智能体能够在没有人工审批的情况下执行维修或生产决策。
代码和权重已开放,企业部署仍要核对许可
Timestral的推理代码已发布在Mistral的GitHub仓库,模型权重则通过Hugging Face提供。根据模型卡,权重采用修改版MIT许可;代码仓库和模型权重的许可范围需要分别核对,企业不能仅因为代码可以公开获取,就默认所有商业部署方式都不受限制。
对于需要适应自身数据的企业,Mistral还提供Mistral Forge,用于添加领域特定协变量、使用专有数据微调模型,以及控制训练数据和合成数据的组合。Mistral称,相关训练流程可以部署在客户自己的硬件上,包括物理隔离环境。
不过,模型开放、可在CPU上运行和已经完成生产部署是三个不同层次的事实。Timestral目前最明确的变化,是把时间序列基础模型的参数规模和推理门槛进一步压低;它能否在具体行业中持续优于传统模型或针对单一数据集训练的模型,仍取决于后续技术报告、独立评测和真实业务验证。