英伟达在 Hugging Face 发布了 Kumo Forecast,一种结合预训练时间序列表示与历史模式检索(DARR)的预测模型。模型以MOMENT-1-large为骨干,提供可解释性输出和DataFrame接口,代码与权重已开源但仍需在生产环境中经严格验证。
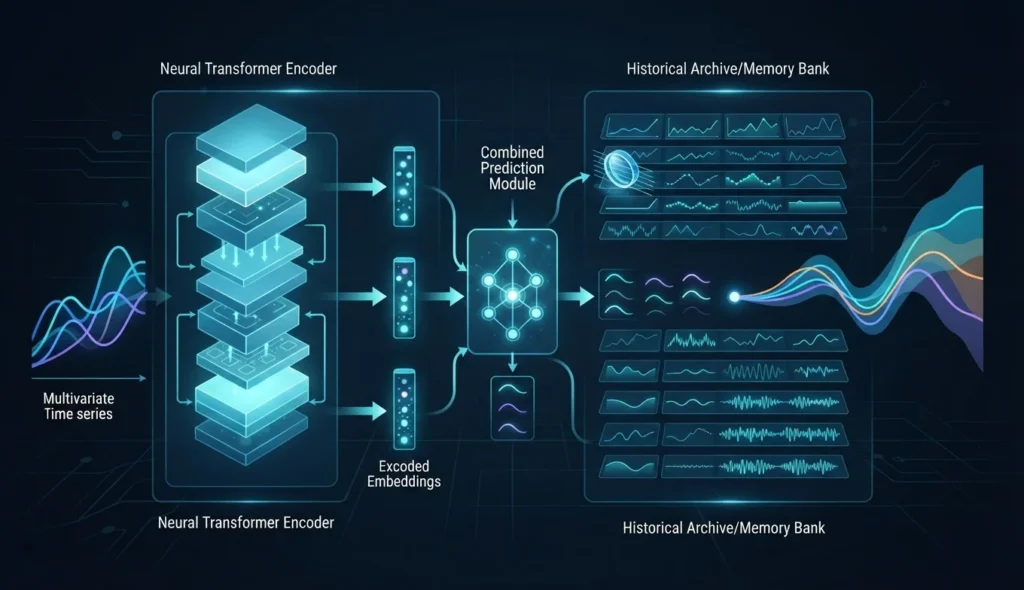
英伟达(NVIDIA)在 Hugging Face 发布了时间序列预测模型 Kumo Forecast。这个模型的重点并不只是使用Transformer处理多变量数据,而是尝试把两种信息来源放在同一个预测流程中:一方面利用预训练模型从近期观测中提取表示,另一方面从历史数据中检索相似模式,再将两者结合为最终预测。
NVIDIA在官方介绍文章中说,Kumo Forecast此前称为NV-Tesseract Forecasting,采用Domain-Aware Representation and Retrieval(DARR,领域感知表示与检索)机制。模型代码已发布在NVIDIA/Kumo-TS代码库,模型权重则放在Hugging Face的nvidia/Kumo-Forecast页面。官方页面显示,这篇介绍发表于2026年10月21日;模型卡则保留了此前的NV-Tesseract命名和2026年4月7日的模型发布日期,反映出项目在更名和产品化过程中的时间差异。
从直接预测到带历史上下文的预测
传统的时间序列预测通常把最近一段观测作为输入,让模型直接生成未来若干步的数值。Kumo Forecast仍然保留这条路径:以近期数据为输入,经过基于MOMENT的Transformer编码器和可训练的预测头,输出指定预测范围内的结果。
DARR模式增加了第二条路径。系统会从一份独立的历史数据表中寻找与当前输入相似的时间模式,再用近邻检索结果辅助直接预测。换言之,模型的输入窗口与检索上下文并不是同一件事:前者描述“现在发生了什么”,后者提供“历史上是否出现过类似情况”。开发者还可以通过配置调整直接预测与历史检索在最终结果中的相对作用。
这种设计尤其适合那些存在季节性、重复运行周期或设备运行状态变化的场景。例如,工厂设备可能在不同维护周期中出现相似的温度和振动走势,电力负荷也可能在节假日、天气或特定生产安排下重复出现。检索历史模式并不能保证未来会复制过去,但可以为模型提供单纯预训练表示之外的应用现场信息。
340 million参数骨干与可解释性框架
根据Kumo-Forecast模型卡,模型使用MOMENT-1-large作为骨干,基础编码器约有3.4亿参数,编码器和嵌入器权重保持冻结,主要训练面向预测任务的预测头。MOMENT本身是一个面向通用时间序列分析的开放基础模型,相关研究介绍见其arXiv论文。
Kumo Forecast还把解释结果作为预测流程的一部分。启用解释功能后,系统可以输出按预测步划分的滞后特征归因和变量归因,并提供语义流、轨迹稳定性等诊断信息,还可以选择使用基于嵌入的Integrated Gradients。NVIDIA强调,这些解释不需要更换底层预测器,而是伴随预测结果生成。
这使它与只给出一串未来数值的预测接口有所不同。在工业维护、能源调度或库存管理中,使用者往往不仅要知道“未来可能是多少”,还要判断模型主要参考了哪些历史滞后、哪些变量,以及预测轨迹是否稳定。不过,解释结果说明的是模型如何形成预测,并不等于证明预测本身正确,也不能替代对数据质量和业务逻辑的审查。
面向表格数据的接口和明确限制
Kumo Forecast采用以DataFrame为中心的接口,输入需要包含时间戳列以及一个或多个数值列,也可以使用CSV或JSON。模型卡列出的支持序列长度为256、512、1024和2048个观测点;如果预测范围超过模型的原生能力,系统可以采用自回归方式延长预测。
在DARR模式下,历史上下文还需要与输入数据保持相近的维度。模型面向的是数值型时间数据,并不是可以直接处理任意文本、图片或未经整理的业务数据库的通用智能体。部署时,数据清洗、缺失值处理、采样频率统一、时间切分和异常点处理,仍然是预测系统的重要组成部分。
NVIDIA建议,使用者在具体应用中对直接预测和检索增强配置进行对照测试,并在目标预测周期和实际运行条件下使用留出窗口验证质量。这个提醒很重要:历史模式检索可能帮助模型应对领域变化,但如果历史库存在偏差、过时数据或与当前场景不匹配的模式,检索结果也可能把模型带向错误方向。
开放代码降低试验门槛,但不等于完成生产验证
Kumo Forecast以Apache 2.0许可证发布,Kumo-TS代码库提供预训练推理流程,也提供使用用户自有CSV进行微调的示例。NVIDIA文档把Kumo Forecast列为时间序列预测模型,与同一Kumo家族中的表格和异常检测模型并列;相关产品方向也延续了英伟达此前把基础模型扩展到企业结构化数据的路线。AIFlux此前报道的NVIDIA Kumo Tabular关注的是表格分类和回归,而Kumo Forecast则把相同的基础模型思路带入具有时间顺序的数据。
Kumo Forecast背后的检索式预测方法也有论文支撑。英伟达团队发表于IEEE BigData 2025的《Memory-Augmented Forecasting: Scalability and Generalization Across Temporal Domains》讨论了从时间序列基础模型走向领域感知检索的路线,并报告称检索机制有助于应对复杂目标中的领域变化。论文摘要提供了研究动机和实验结论,但并不等于Kumo Forecast在每个行业数据集上的表现都已被独立验证。
这也是判断这次发布时需要保留的边界。Kumo Forecast已经提供了模型权重、代码、输入限制和解释接口,开发者可以据此开始试验;但公开模型的可获得性、论文中的基准结果和企业生产环境中的稳定收益,仍是三个不同层次的事实。对于需要高可靠预测的场景,真正需要观察的将是它在时间外推、分布变化、历史模式失效和错误解释风险下的表现。
从更大的趋势看,Kumo Forecast代表了时间序列基础模型的一条重要探索路径:模型不再只依赖预训练阶段学到的通用表示,也尝试在推理时访问与当前任务相关的历史记忆。它能否把这种“预测加检索”模式转化为稳定的工业能力,最终仍要由具体数据、业务约束和持续验证来决定。