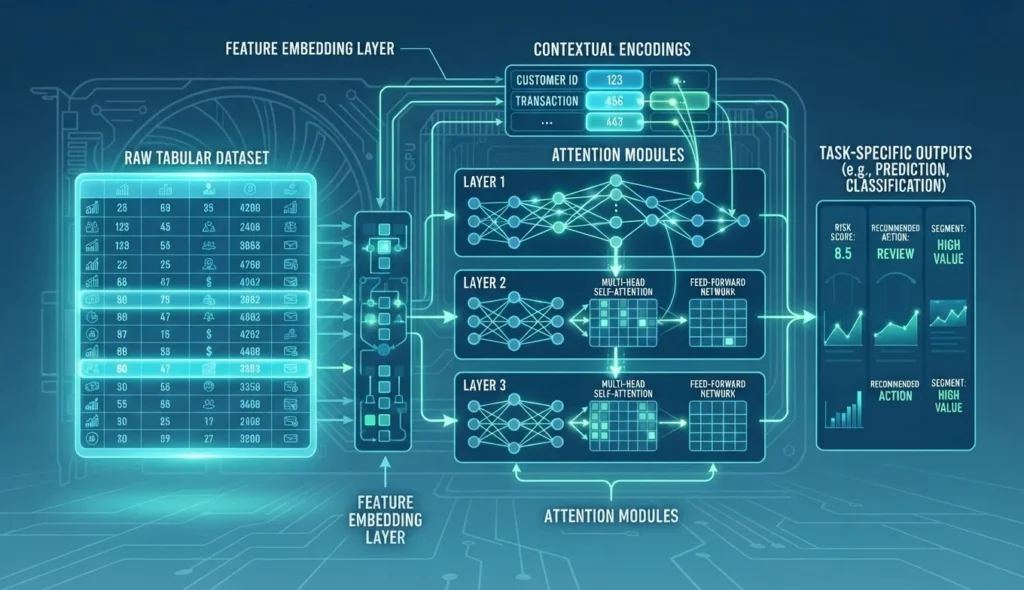
NVIDIA 发布了面向表格数据的开源基础模型 Kumo Tabular,支持通过提供带标签的上下文行在一次前向推理中完成分类和回归预测,无需针对每个任务重新训练。模型权重已在 Hugging Face 开放,采用合成表格预训练并在多项公开基准上取得领先成绩,但在真实业务场景中的稳定性与适用性仍需进一步检验。
英伟达(NVIDIA)发布了面向表格数据的开放基础模型 Kumo Tabular。该模型由 NVIDIA Kumo Structured 系列团队开发,现已在 Hugging Face 开放模型权重,并通过开源的 structured-data-models代码库提供推理支持。
与传统表格机器学习模型需要针对每个任务重新训练不同,Kumo Tabular采用上下文学习方式:用户向模型提供一张包含特征和标签的表格,以及需要预测的新行,模型便可在一次前向推理中返回分类概率或回归结果。NVIDIA表示,模型不需要针对当前任务重新训练、调参或进行传统意义上的特征工程。
这项发布的意义不在于表格数据第一次使用Transformer,而在于基础模型范式正在从文本、图像等领域向企业数据库中更常见的结构化数据延伸。表格数据往往直接对应客户、交易、订单、传感器、保险理赔和供应链记录,企业最常见的机器学习任务——例如流失预测、违约判断、需求预测和价格预测——长期以来主要由梯度提升树等方法承担。
从每个任务单独训练,到把数据作为上下文
在传统流程中,企业需要为每一个新问题准备标签、清理数据、设计特征、搜索超参数、验证模型,再把结果部署到生产环境。模型通常只学习当前数据集,很难把在其他表格任务中获得的经验直接迁移过来。
Kumo Tabular采用的是类似大语言模型上下文学习的思路。模型在预训练阶段学习大量人工生成的表格结构,推理时则把用户提供的带标签行当作“上下文”,再根据这些示例预测未标注行。换言之,模型参数不需要在每个新任务上更新,任务信息主要通过输入的表格传递。
NVIDIA称,Kumo Tabular面向分类和回归两类任务,并提供Small、Medium和Large三个版本,参数规模约为2800万至2.15亿。模型权重已发布至Hugging Face的Kumo-Tabular页面,使用OpenMDW 1.1许可证。
模型如何理解一张表
Kumo Tabular是一种围绕表格结构设计的Transformer。其架构借鉴了TabICL和TabPFN等表格基础模型的思路,分别处理单元格、行与上下文之间的关系。
首先,模型将一组单元格组织成token,并分别处理数值型和类别型数据。缺失值不必先用均值或其他固定值填补,而是由模型以特殊方式处理。之后,模型通过列注意力理解某个数值在所在列中的相对位置,再通过行注意力学习同一行中不同特征之间的关系。
在最后的上下文学习阶段,带标签的上下文行彼此交互,待预测的查询行则读取上下文信息。对于回归任务,模型不仅输出点预测,还通过多个分位数给出不确定性估计。NVIDIA还设计了随表格规模变化的注意力温度机制,以避免当上下文行数量增加时,注意力分布变得过于分散。
这种设计试图解决表格基础模型面临的一个核心问题:表格既不像文本那样具有天然的顺序,也不像图像那样具有固定的空间结构。交换两行或两列通常不应改变数据含义,模型必须依靠列的统计分布、行内特征关系以及带标签样本之间的联系来完成预测。
只用人工数据预训练,能否覆盖真实世界的混乱
NVIDIA表示,Kumo Tabular完全使用人工生成的表格进行预训练。训练数据生成器基于结构因果模型,随机生成因果图、变量、函数机制、列类型、目标值和缺失模式,再加入异常值、重尾分布、类别数量过多以及同一特征组合对应不同标签等现实数据中常见的复杂情况。
按照发布说明,Small、Medium和Large版本在训练过程中分别见过约3500万、7100万和1.37亿张人工表格。训练分为多个阶段,表格规模从约1024行逐步扩展到最多6万行,特征列最多达到100列。NVIDIA称,相关训练配方和人工数据生成器将在稍后开放。
这种路线延续了TabICL论文所代表的研究方向:通过在人工任务上预训练模型,推理时直接利用新数据进行上下文学习。TabICL的研究显示,这类方法可以在不更新模型参数的情况下处理较大规模的表格任务,但人工分布与真实业务分布之间的差异,仍然是表格基础模型能否稳定落地的关键问题。
NVIDIA称四项基准测试排名第一
在性能部分,NVIDIA表示,Kumo Tabular以默认设置参加了TabArena的完整评测,在包括调优后的梯度提升树、AutoGluon以及其他表格基础模型的比较中,整体ELO达到1950并排名第一。公司还报告称,模型在BeyondArena、TALENT和ScoringBench上同样取得第一或前列成绩:
- 在BeyondArena上,Kumo Tabular的ELO为1418,Improvability得分为7.78%,排名第一;
- 在TALENT上,模型在分类准确率、分类对数损失和回归RMSE三个方向均排名靠前;
- 在ScoringBench这一关注预测分布的基准中,Large和Medium版本平均排名分别为第一和第二。
这些结果来自NVIDIA对Kumo Tabular的发布说明,属于公司公布的基准测试结果。不同基准的数据集构成、任务切分、硬件环境和评测配置都会影响排名,因此,榜单成绩并不能直接等同于所有企业场景中的实际效果。尤其是表格预测通常高度依赖业务领域、时间切分方式和标签泄漏控制,生产部署仍需要独立的留出集和校准测试。
开放权重之外,推理效率也是竞争焦点
Kumo Tabular的另一项卖点是推理流程。官方库负责从Pandas表格完成张量化、预处理、集成以及多类别处理,模型首次使用时会从Hugging Face下载权重。用户可以将带标签的行作为上下文,将未标注行作为查询输入,在GPU上直接获得预测结果。
这意味着,企业在面对一个新预测任务时,理论上可以先用已有标注数据进行零样本或少量上下文推理,而不必立即建立完整的训练流水线。不过,“无需训练”并不意味着“无需验证”:数据分布变化、查询行与上下文行来自不同分布、类别数量过多或表格规模远超训练范围,都可能导致精度下降。
NVIDIA在限制说明中明确指出,Kumo Tabular原生面向数值型和类别型列;文本、图像和时间戳需要先通过预处理方案转换为可用特征。单次前向推理最多覆盖10个类别,更多类别则由库通过纠错输出码扩展。模型也可能在超出训练范围的表格,或查询数据与上下文数据分布不一致的场景中退化。
这类限制解释了为什么表格基础模型的竞争不会只围绕参数量或排行榜展开。与NVIDIA此前强调合成数据和数据评估体系的工作类似,真正影响企业采用的还包括数据生成是否可解释、评测是否可复现、预测是否能给出可信的不确定性,以及模型是否能够在现有硬件和数据治理体系中运行。
表格基础模型仍需面对现实业务的检验
从技术路径看,Kumo Tabular把大模型时代的“上下文即任务”理念带入了传统企业机器学习领域。它试图让同一个预训练模型面对不同表格时,通过输入样本而不是参数更新来适应新问题,并将分类、回归和不确定性估计放入统一的推理接口。
但这条路线能否取代梯度提升树,尚不能仅凭一次发布下结论。梯度提升树经过多年产业验证,在中小规模结构化数据、可解释性要求和CPU部署方面仍具优势;表格基础模型则可能在减少建模准备工作、跨任务迁移和快速试验方面更有吸引力。两者最终可能长期并存,而不是简单的替代关系。
接下来需要观察的,是Kumo Tabular开放训练配方和数据生成器后能否让外部研究者复现实验结果,以及模型在时间外推、类别极不平衡、隐私敏感数据和跨行业迁移中的表现。对企业用户而言,最重要的问题也许不是它是否在公开榜单上排名第一,而是它能否在自己的留出数据上,以可接受的成本提供稳定、可校准且可持续维护的预测。