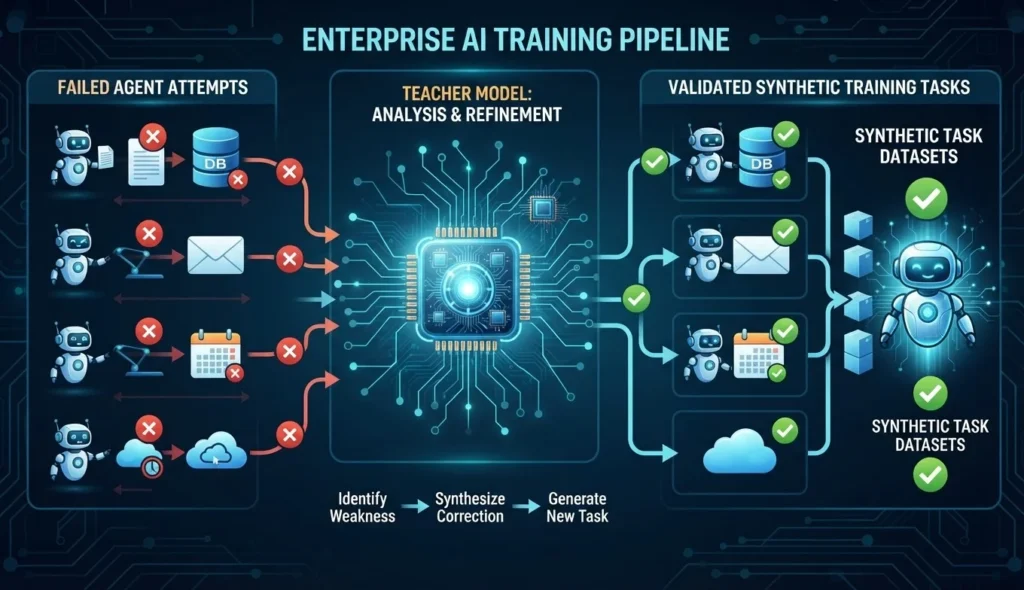
ServiceNow AI Research 在 Hugging Face 发布 AutoSynthData,一种基于目标模型失败轨迹并借助更强教师模型生成、验证和修复合成训练数据的方法,旨在为企业智能体在真实工作流中补齐能力缺口并提高通过率。团队在 EnterpriseOps Gym 基准上进行了实验,展示了在多种企业场景下通过合成样本对模型性能的实质性提升,同时强调严格的执行与验证环节以保证数据质量。
ServiceNow AI Research团队在Hugging Face发表文章,介绍了一套面向企业智能体的合成训练数据生成方法AutoSynthData。该方法不把训练任务视为静态题库,而是先观察目标模型在企业工作环境中的失败,再借助更强的“教师”模型判断哪些任务可行、成功路径是什么,最后生成、验证并修复一批新的训练任务。
这篇文章发表于Hugging Face博客,日期为2026年10月2日。作者来自ServiceNow CoreAI,包括Esakkivel Esakkiraja、Shruthan Radhakrishna、Denis Akhiyarov和Sagar Davasam。
企业智能体的难题不只是“会不会回答”
在企业软件中,智能体面对的不是一张可以独立完成的问答试卷。它需要理解当前系统状态,选择合适的工具,遵守组织政策,并通过一连串操作把数据库或业务系统带到正确的最终状态。
因此,一个模型即使具备广泛的通用能力,也可能在特定企业环境中反复出错:它可能误用工具、遗漏审批条件、无法处理复杂的跨系统流程,或者在看似合理的操作后留下错误的最终状态。
ServiceNow团队将一个可用于训练的智能体任务抽象为三个部分:系统规范、面向智能体的用户请求,以及验证器。系统规范定义指令、环境政策和初始数据状态;用户请求说明要完成的工作;验证器则负责判断最终结果是否真正符合要求。
其中,任务需要同时满足三个条件:可执行、像真实用户需求一样合理,并且足够困难,能够暴露当前模型的能力缺口。任务不能依赖环境中不存在的工具,也不能只靠人为加入的苛刻限制来制造难度。
AutoSynthData如何把失败变成课程
AutoSynthData首先在目标环境中运行诊断任务,分析目标模型在哪里失败,以及更强的教师模型如何完成同一类工作。系统会提取需要测试的能力、涉及的工具和工作流、目标模型的失败方式、正确最终状态应具备的属性,以及可以变化而不改变核心能力的任务维度。
这些信息会被整理成经过清理的“能力规格卡”。生成器不会直接看到原始评测任务的提示词、实体、执行轨迹或验证器细节,而是依据规格卡生成新的任务。这样做的目的,是让训练样本学习可迁移的能力,而不是记住原题或复制某一条固定路径。
系统将数据构建分成两个阶段。第一阶段“Target”生成核心样本:并行工作的生成器提出任务,任务随后接受验证、执行、求解器评估和修复。第二阶段“Multiply”则从已经通过检查的核心样本出发,生成新的请求、环境状态、实体组合、参考轨迹和验证器。每个变体都必须重新通过同样的检查,而且一个扩增样本不能继续作为另一个扩增样本的种子,以减少多代生成带来的偏移。
关键不在生成,而在验证
ServiceNow团队强调,生成一条看起来合理的用户请求,并不等于得到了可用于训练的数据。任务可能根本无法执行,参考轨迹可能无法在环境中重现,验证器也可能错误地奖励一个不符合要求的结果。
因此,AutoSynthData设置了多重质量控制。正向验证会执行参考轨迹,检查它是否能把环境带到验证器要求的状态;负向验证则会修改预期结果的一部分,确认相关错误状态不会被验证器接受。如果候选样本失败,批评器会判断问题来自初始状态、工作流、参考轨迹、任务构造还是验证器逻辑,并在有限次数内进行定向修复。
文章还将质量审查延伸到批次层面。一个批次即使每个样本单独看都有效,也可能过度集中在少数简单任务,遗漏关键能力,或者反复生成相似的例子。元审查会检查样本覆盖度、重复模式、失败的生成目标和批评意见,再把结果反馈给下一批任务的生成策略。
这种设计与近期关于智能体不能只看一次成功的评测研究形成了互补:前者关注重复执行时的稳定性,AutoSynthData则试图把模型暴露出的能力缺口转化为下一轮训练样本。
在EnterpriseOps Gym中的实验结果
ServiceNow团队使用EnterpriseOps Gym测试这套方法。该项目是一个面向企业工作流的容器化、可重置评测环境,任务覆盖日历、客户服务、云盘、电子邮件、人力资源、IT服务管理、团队协作以及跨领域的Hybrid场景。任务在交互式环境中执行,最终结果由数据库状态验证器检查,而不是只按照一条预设操作轨迹评分。
关于这一基准的环境、代码和任务说明,可参见ServiceNow在GitHub发布的EnterpriseOps-Gym项目以及项目主页。对应的公开数据集也已发布在Hugging Face Datasets上。需要注意的是,公开页面之间存在版本或统计口径差异:GitHub和项目主页描述为1,150项任务,而Hugging Face数据集页面当前的汇总表显示总数为1,115项。本文将两者视为同一基准的不同公开统计,不能在没有进一步版本说明的情况下把差异解释为新增或删除了具体任务。
在Hybrid实验中,团队以Gemma-4-26B-A4B-it作为目标模型,以Qwen3.8-27B作为教师模型。AutoSynthData在约18小时内生成2,000条合成训练样本,经过监督微调后,最佳检查点为第5个epoch。研究人员报告称,模型的平均Pass@1提高了7.2个百分点,相对提升35%;验证器通过率则从63.01%升至68.55%。按团队的计算,这一结果弥补了目标模型与参考模型之间原始Pass@1差距的59%。
在ITSM环境中,目标模型仍为Gemma-4-26B-A4B-it,教师模型改为DeepSeek-V4.1-Flash。AutoSynthData生成了1,994条训练样本,用时66小时;合成监督微调后,平均Pass@1从18.77%升至27.18%。
这些结果来自ServiceNow团队在特定环境、模型和训练设置下的实验。它们说明方法在EnterpriseOps Gym中带来了改善,但不等同于证明同样幅度的提升可以直接迁移到所有企业系统或生产环境。
从静态数据集转向“移动的能力边界”
AutoSynthData的核心思路,是把训练数据生成目标放在模型当前能力边界附近:任务要足够困难,能够暴露模型的弱点;同时又必须可执行,并且能由教师模型提供可靠的成功示范。模型经过训练后,原先已经能够稳定完成的任务价值下降,持续失败的任务则成为下一轮生成的重点。
这也解释了为什么企业智能体训练越来越依赖环境本身。企业工作流中的能力不是脱离系统存在的抽象技能,而是与权限、工具、数据状态、审批制度和最终结果绑定在一起。对一个客户服务任务有效的训练样本,未必能直接迁移到IT服务管理;一个在沙箱中通过验证的轨迹,也不意味着它已经适合接触真实的企业数据。
ServiceNow表示,目前实验主要集中在监督微调,但同一机制未来也可以用于强化学习:持续生成挑战当前策略的任务,提供可靠的学习信号,再根据更新后的策略重新移动任务难度。真正需要验证的问题,将是这种由失败驱动、经过环境验证的课程,能否在更广泛的企业系统中保持数据质量和能力迁移。
对于企业用户而言,AutoSynthData带来的重要变化,或许不是“合成数据”这个概念本身,而是训练数据生成开始更直接地连接到生产工作流中的具体失败。智能体是否能够进入企业,最终仍取决于它能否在受控权限下稳定完成任务、正确处理不可行请求,并在每一次执行后留下可核验的系统状态。
来源:Hugging Face:AutoSynthData: Generating Training Data for Enterprise Agents;EnterpriseOps-Gym项目主页;GitHub代码仓库;Hugging Face公开数据集;EnterpriseOps-Gym论文(arXiv)。