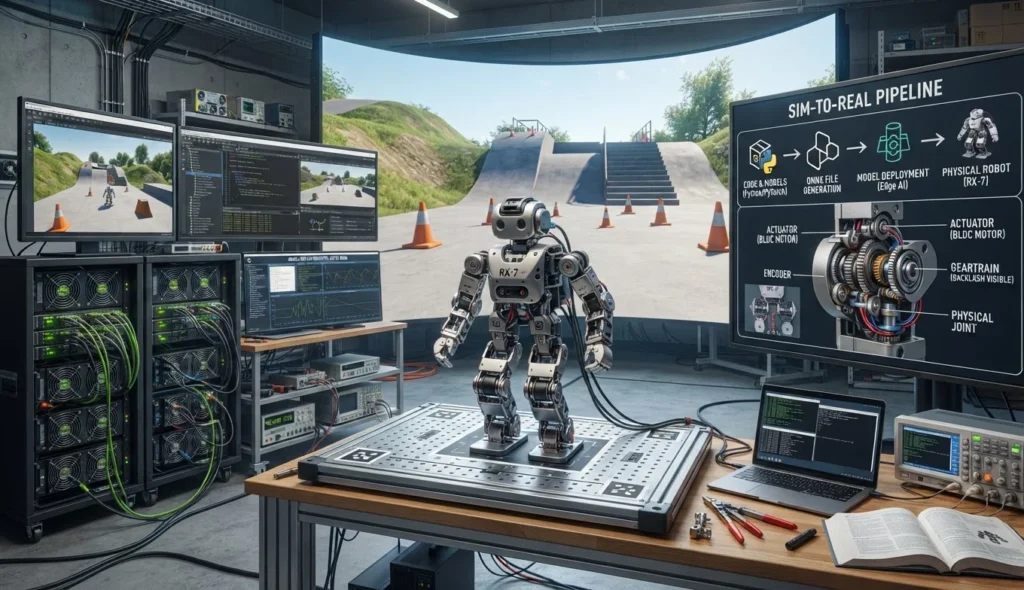
Hugging Face 与英伟达演示了使用 Isaac Lab 3.0 和 Newton 在仿真中训练 Pollen Robotics 的开源双足机器人 Microduck,并导出 ONNX 部署到真实硬件的完整 sim-to-real 工作流。教程展示了域随机化、机械间隙建模、多 GPU 并行训练与在 Hugging Face Hub/Arena 上共享与评测策略的流程与注意点。
一只高约25厘米、重约800克的开源双足机器人,正在成为英伟达展示物理人工智能开发流程的一个小型样板。
10月21日,Hugging Face 发布教程,介绍如何使用 NVIDIA Isaac Lab 3.0 和 Newton,为 Pollen Robotics 的 Microduck 训练行走策略,再将模型导出为 ONNX,部署到真实机器人上。开发者还可以把策略上传到 Hugging Face Hub,在 Microduck Arena 中与其他策略比较,或继续扩展到崎岖地形、感知和操作任务。
这篇题为《Train in Simulation, Deploy on a Real Robot: Microduck with Isaac Lab 3.0》的文章,本质上不是一次单独的机器人产品发布,而是一次从模拟器、强化学习训练到实体硬件部署的完整工作流演示。它试图回答物理 AI 开发中的一个核心问题:在不反复损坏真实机器人、也不为每种动作采集大量现实数据的情况下,如何让机器人学会新的技能。
Microduck 把“可训练”作为产品的一部分
Microduck 由 Pollen Robotics 与 Hugging Face 推出。Pollen Robotics 的产品页面显示,这是一款面向强化学习实验的25厘米开源双足机器人,配备15个电机、摄像头、激光雷达和两个惯性测量单元,机载策略循环频率为50Hz。产品页面列出的入门价格为399美元,具体税费和运输费用另计。
与许多主要依靠预设动作或封闭软件运行的消费级机器人不同,Microduck 的定位是让用户重新训练和发布行为策略。Pollen Robotics 表示,其 SDK、仿真环境和完整的强化学习训练栈均已开放,机器人运行的策略可以被阅读、修改和重新训练。项目软件采用 Apache 2.0 许可证,但三维模型文件另有非商业许可限制,二者不能混为一谈。
目前,Microduck 已经可以执行行走、坐下与站立、踢球、抓取、滑轮滑行和摔倒后起身等动作。对开发者而言,这些动作更重要的地方不在于展示效果,而在于它们可以被视为可替换、可评估的策略模块。
仿真策略为何不能直接照搬到现实
机器人在模拟环境中学会走路,并不意味着它能在现实地面上稳定行走。真实伺服电机存在摩擦、响应延迟、电池电压变化和齿轮间隙;地面材质、机器人质量分布和传感器误差也不可能与仿真完全一致。
Hugging Face 的教程因此没有把仿真简化为一个理想化的“数字玩具”。在 Isaac Lab 中,Microduck 的行走任务包含机器人模型、场景、观测值、动作、奖励函数和域随机化设置。开发者可以从平坦地面任务开始,也可以使用包含楼梯、坡道和不平地形的 rough terrain 变体。
策略接收61个观测值,并输出14个关节位置值。导出和部署时,观测顺序、归一化方式以及动作缩放必须保持一致,否则同一个 ONNX 文件在真实机器人上可能会产生错误动作。
在训练过程中,系统会随机改变机器人质量和质心、地面摩擦、关节惯量、编码器偏移、电池电压与电压跌落、指令延迟,以及不同关节的机械间隙。训练还会加入不同地形和外力推搡,让策略接触到现实中可能出现的变化。
教程特别强调了 backlash,也就是齿轮传动中的机械间隙。当关节改变运动方向时,传动机构可能会先发生一段空行程,随后才重新啮合。如果仿真完全忽略这一点,策略可能只在理想电机模型中有效;把这一效应纳入训练,则有助于缩小从模拟到现实的差距。
Isaac Lab 3.0 把训练规模推向 GPU 并行
英伟达对 Isaac Lab 的介绍将其定义为一个开源、GPU 加速、面向机器人学习的仿真框架。它支持强化学习和模仿学习,并可以在 Newton、PhysX、Warp 和 MuJoCo 等物理引擎之间扩展工作流。
在 Microduck 教程中,Isaac Lab 同时运行大量模拟环境,让机器人在不同条件下并行练习。教程给出的训练配置使用4096个环境;在启用崎岖地形和机械间隙的设置下,文章称16 GPU配置最高可达到每秒125万步。这个数字来自教程团队的特定硬件和配置,不能直接理解为所有工作站都能达到的通用性能。
Newton 则承担了更接近真实伺服系统的物理建模。教程使用 Newton 的 MJWarp 求解器和基于 Newton 的 Better Actuator Models,对伺服响应、摩擦、延迟以及电机和固件控制器的限制进行建模。
这类设计反映出物理 AI 开发的一个变化:仿真器不再只是用来生成好看的机器人动画,而是开始承担训练、评估和部署前验证的基础设施角色。英伟达在10月21日发布的Isaac 平台更新中称,Isaac Lab 3.0 已正式可用,并将多 GPU 训练、Newton 等物理引擎和从桌面到数据中心的机器人策略开发连接起来。
从检查点到 ONNX,再到真实的 Microduck
完成训练后,开发者可以在 Newton 可视化环境中回放最新检查点,先观察策略在模拟环境中的表现。RSL-RL 的回放流程会自动导出 TorchScript 文件和 ONNX 文件,后者用于 Microduck 的机载运行时。
部署流程并不复杂,但每一步都对应一个质量控制点:先检查策略在仿真中的行为,再确认61维观测和14维动作接口,随后把 policy.onnx 复制到机器人,使用机器人软件列出和加载策略,并在机器人被支撑的状态下测试站立、慢速行走、转向和停止。
教程展示的真实机器人还需要面对摔倒后的恢复问题。策略不仅要在平地上向前移动,还要在机器人被推倒后重新找到稳定姿态。对真实硬件来说,这比模拟器中的一次成功回放更能说明策略是否具有可部署性。
不过,“能够部署”并不等于“已经解决了 sim-to-real”。Microduck 的尺寸、执行器和任务范围相对有限,教程中的成功也主要针对行走策略。更复杂的抓取、视觉导航和多物体交互,仍会受到传感器噪声、碰撞建模、控制延迟和现实环境变化的影响。
开放策略和竞赛机制能否形成反馈循环
导出 ONNX 之后,开发者可以把策略上传到 Hugging Face Hub,并配套提供模型卡和训练配置。这样,其他用户不仅可以下载策略,也可以了解它是在什么任务、什么地形和什么随机化条件下训练出来的。
Hugging Face 还提供 Microduck Arena,用于测试兼容策略并比较结果。Arena 要求策略满足61个观测值、14个动作值的接口,模型文件大小上限为64 MiB。该限制将策略分享从单纯上传文件,变成了一个带有接口和资源约束的评估流程。
Pollen Robotics 的 Microduck Arena页面将其描述为一个可提交、竞争和重复训练的官方竞赛空间。这样的机制有可能形成一种开放反馈循环:开发者在模拟器中训练策略,在公共环境中比较,再将改进后的策略部署到真实机器人。
但排行榜也不能替代现实测试。不同策略在共享模拟任务中的得分,未必能完整预测它们在不同地板、不同电池状态或不同机械磨损程度下的表现。对于物理 AI,模拟器中的统一评测和实体机器人的长期稳定性仍然是两套需要连接、但不能互相替代的证据。
从会走路到感知和操作
教程将行走称为起点,而不是终点。Isaac Lab 3.0 还支持更复杂的运动、视觉和灵巧操作任务。Microduck 可以继续加入头部摄像头的 RGB、深度和分割观测,尝试在坡道或平台之间导航;开发者也可以参考 Kuka–Allegro 任务,训练机械臂和多指手完成物体操作。
英伟达也在把仿真资产和机器人学习工具放到更大的开放生态中。AIFluxNews 此前报道的SimReady Central提供了超过2000个面向机器人和 AI 工厂数字孪生的仿真准备资产。对训练系统来说,标准化模型、物理属性、碰撞几何和语义标签,与强化学习框架本身同样重要。
与此同时,物理 AI 的计算也不一定全部放在机器人本体上。微软研究对物理 AI 推理卸载的测量显示,边缘或云端 GPU 可以缓解机载算力和电池限制,但延迟、带宽和视频压缩会影响闭环控制。Microduck 的教程则代表另一条路线:尽可能在训练阶段把执行器误差和现实变化纳入模型,并将轻量策略直接部署到机器人。
这两条路线并不互相排斥。对延迟敏感的低层控制,通常需要在本地快速执行;对高层规划、数据分析和集中式训练,边缘或云端算力可能更合适。未来的机器人系统很可能同时依赖高保真仿真、本地控制和分布式基础设施。
Microduck 的意义正在于把这条链路压缩到一个普通开发者可以理解和尝试的项目中:在模拟环境里训练,在开放平台上分享,在公共任务中评估,最后把策略放回真实机器人。它没有消除物理 AI 的复杂性,却让“从代码到动作”的过程变得更具体,也更容易被社区检验。
来源: