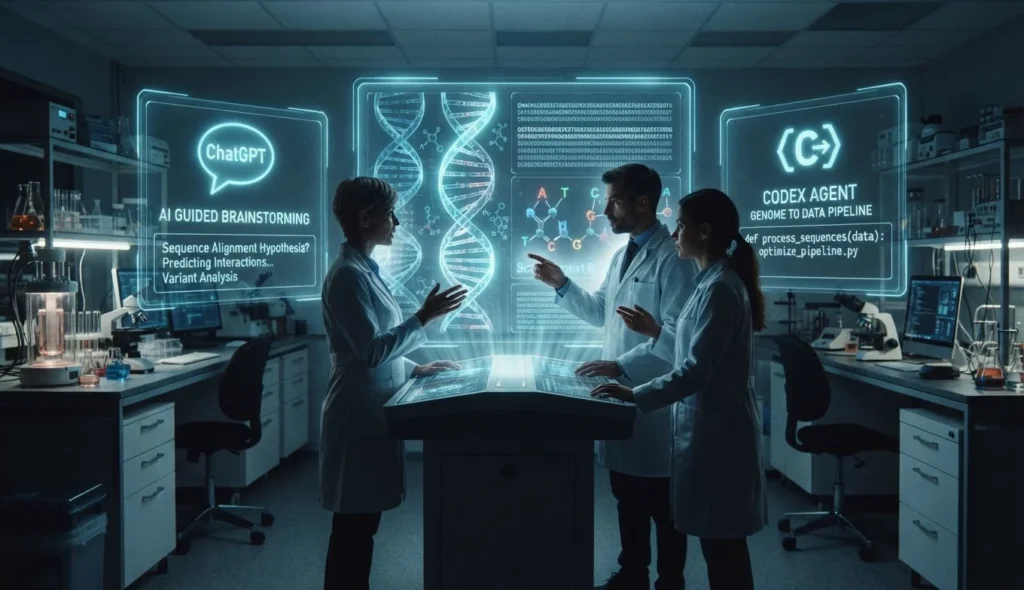
OpenAI 展示了研究团队如何将 ChatGPT 与 Codex 及实验室自有的机器学习模型结合,用于从基因组和蛋白质序列中大规模筛选潜在抗菌分子,显著加速候选物识别流程,但最终仍需实验验证与临床开发。该方法更多是科研工作流与基础设施的变革,而非直接推出可供临床使用的新药。
OpenAI 展示了一种正在生命科学实验室中形成的工作方式:研究人员不再只把 ChatGPT 当作问答工具,而是把它与 Codex 以及实验室自身的机器学习模型结合起来,用于提出假设、编写代码、处理基因组数据和整理实验结果。
这项工作由宾夕法尼亚大学生物工程师 César de la Fuente 及其团队开展。团队的目标,是从活着的、已经灭绝的,甚至极端环境中的生物所留下的基因组和蛋白质信息中,寻找可能对抗耐药感染的分子。
不过,OpenAI 的这篇介绍并没有宣布一种已经获批的新药,也没有声称 ChatGPT 独立发现了可以直接用于临床的抗生素。它更像是一份关于科研工作流的案例说明:人工智能可以把寻找候选分子的早期阶段从“逐个试验”变成大规模计算筛选,但最终仍需要实验、毒性测试、药代动力学研究和临床试验来证明候选物是否真的有用。
耐药性危机把“寻找新药”变成了一场数据搜索
抗微生物药物耐药性已经不只是医院内部的医学问题。世界卫生组织表示,细菌耐药性在 2021 年与全球超过 470 万人的死亡有关;2023 年,全球常见感染中每六例实验室确认的细菌感染,就有约一例对抗生素产生耐药性。
世界卫生组织对抗微生物药物耐药性的概述还指出,现有研发管线中的创新药物数量不足以应对不断扩大的威胁。抗生素的误用和过度使用会加速耐药性传播,而新药开发本身又通常需要多年时间,并且失败率很高。
传统寻找抗菌药物的方法,往往从土壤、植物、动物、微生物或其他自然样本中提取物质,再逐一检测其是否能够杀死目标病原体。这个过程仍然重要,但样本空间极其庞大,研究人员很容易面对一个“针在 haystack 中”的问题:可能有价值的分子数量远远超过实验室能够逐一测试的数量。
de la Fuente 团队采取的思路,是把生物学看成一种信息系统。DNA 中的核苷酸、蛋白质和多肽中的氨基酸,可以被视为一种“字母表”。机器学习模型则尝试从这些序列中识别与生物活性有关的模式,进而筛出值得进一步实验的候选分子。
根据团队的研究介绍,他们已经从人类蛋白质组扩展到不同生物的蛋白质组、基因组和宏基因组,并把寻找临床前候选物所需的早期时间从数年压缩到数小时。这里的“数小时”描述的是计算筛选和候选识别阶段,并不意味着一种药物可以在数小时内完成开发。
ChatGPT 与 Codex 分工不同,但共同嵌入研究循环
OpenAI 描述的工作流并不是让一个聊天机器人替代实验室,而是把多个环节连接起来。
ChatGPT 被用作头脑风暴和协作讨论的工具。研究人员可以让它帮助澄清陌生领域的术语、比较不同实验方法、组织研究问题,并把来自不同学科成员的想法放到同一个讨论空间里。对于由生物学家、化学家、计算机科学家和工程师组成的跨学科团队来说,这种能力可以降低沟通成本。
Codex 则更接近一个编程和数据处理代理。实验室成员可以让它编写或修改程序、下载和整理大型基因组数据集、执行预处理流程,并协助分析模型输出。对不熟悉某一编程语言的生物学家来说,这意味着他们可以更直接地把一个研究问题转化为可运行的计算任务;对程序员来说,则意味着更容易进入需要生物学和化学知识的研究场景。
OpenAI 还特别提到,团队成员会用 ChatGPT 和 Codex 连接不同学科之间的概念,并在自己的母语中工作。这些变化看起来不像一次单独的模型发布,却可能改变实验室内部任务的分配方式:研究人员把更多精力放在问题定义、候选筛选和结果判断上,而不是花费大量时间处理重复性的代码和数据整理工作。
从古老生物到“分子复活”
de la Fuente 团队的一个重要研究方向,是从现代生物之外寻找分子线索。他们研究过尼安德特人和丹尼索瓦人等已经灭绝的人类近亲,也研究过其他古老生物的蛋白质信息,并将这种方向称为“分子灭绝复活”或“分子复活”。重点不是让灭绝生物重新出现,而是从已经保存下来的生物序列中推断可能存在的功能性分子,再在实验室中合成和检测它们。
宾夕法尼亚大学 2025 年关于该团队的报道提供了一个具体例子:研究人员利用人工智能分析了 233 种古老微生物——古菌——的蛋白质,识别出超过 12,000 个潜在的抗菌候选物,随后挑选 80 个进行真实细菌实验。这些候选物被称为“archaeasins”。研究人员表示,它们在电荷分布等方面与已知的抗菌肽有所不同。
这类结果说明,人工智能的价值首先体现在扩大搜索范围和提高优先级排序效率,而不是直接替实验室完成药物开发。模型可以指出哪些序列更值得测试,但实验才能判断它们是否真正能够杀死目标细菌、是否会损伤人体细胞,以及是否能够在体内达到有效浓度。
de la Fuente 实验室的研究页面也明确把这些工作称为抗菌候选物和临床前研究方向。页面同时强调,候选分子仍需经过后续开发,才能判断其是否具有治疗价值。
AI 找到候选物之后,最困难的部分才开始
从一个序列或分子被模型标记为“有希望”,到它成为可以给患者使用的药物,中间还有一条很长的链条。
研究人员需要确认候选物是否能杀死目标微生物,确定最低有效浓度,并测试它对人体细胞的影响。化学家可能还要调整分子的结构,以改善稳定性、溶解性、有效性或制造条件。随后还要评估毒性、耐药性风险、在人体内的分布和代谢方式,并建立可重复的生产工艺。
美国微生物学会在一篇关于人工智能抗生素发现的综述中也强调,机器学习可以把庞大的候选空间缩小到更容易实验验证的范围,但从候选物到临床药物仍需要大量资源和时间。该综述指出,AI 可以从活着或灭绝生物的生物蓝图中寻找抗菌分子,也可以从头设计“自然界中原本不存在”的分子;但候选物的临床部署仍是另一项挑战。
这也是 de la Fuente 强调“ground-truth experiments”——真实世界的验证实验——的原因。模型输出无论多么合理,都不能代替培养皿中的测试,更不能代替动物实验和临床研究。研究人员还必须持续检查模型是否产生了错误关联,是否把训练数据中的偏差带进了候选物排序。
这更像科研基础设施的变化,而不是一次产品演示
这项案例的意义,可能不在于 ChatGPT 是否“发现了一种新抗生素”,而在于它展示了 AI 如何嵌入一条真实的科研流水线。
过去,跨学科研究的瓶颈可能是缺少能够同时理解生物学问题、编程工具和数据处理流程的人。现在,ChatGPT 可以帮助成员共享背景知识,Codex 可以把部分自然语言任务转化为代码和数据操作,而专门的机器学习模型则承担候选物预测。实验室由此形成了一个人机协作的循环:提出问题、搜索生物信息、生成候选、进行实验,再把实验结果反馈到下一轮研究中。
但这种模式也有明显边界。第一,OpenAI 的叙述主要来自公司对研究者工作方式的介绍,并不是一项独立的临床疗效评估。第二,模型发现的候选物数量不能直接等同于新药数量。第三,越早使用模型筛选,越需要在后续阶段投入可靠的实验验证,否则快速生成的候选只会增加研究人员的审查负担。
在这个意义上,AI 并没有消除抗菌药物研发的困难,而是把其中一部分困难从“如何找到候选物”转移到“如何验证、优化并推进候选物”。它能够让研究人员更快地搜索生命信息的巨大空间,却不能替人类决定哪一种分子最终安全、有效且能够被制造出来。
对于耐药性危机而言,这种变化仍然重要。药物研发需要的是更多可以被实验检验的好问题、更多有差异化的候选物,以及更高效的失败排除机制。ChatGPT 和 Codex 所代表的工具,可能正在帮助实验室更快抵达这些问题——但答案仍然必须由实验本身给出。
来源: