微软研究院开源 Agent Lightning v1.0,提出“Harnessed Agentic RL”范式,让部署时使用的真实 agent harness 直接参与强化学习训练。该轻量框架兼容 OpenAI API,支持本地或 Kubernetes 调度,并在 SWE-bench 上展示了对编码代理的显著提升,但结果需独立复现并受限于具体 harness、数据和计算预算。
微软研究院于 2026 年 10 月 7 日发布并开源 Agent Lightning v1.0。这个面向智能体强化学习的轻量框架提出“Harnessed Agentic RL”训练范式:不再把智能体的工具调用、上下文管理和控制流程重新改写进训练系统,而是让部署时使用的真实 agent harness 直接参与强化学习。
微软研究院称,Agent Lightning v1.0 的完整控制平面约有 3,500 行代码,并通过一个兼容 OpenAI API 的大语言模型代理,把现有智能体与训练流程连接起来。以编码智能体为例,研究团队使用 Qwen3.5-9B 和约 6,000 个训练样本,在 SWE-bench Verified 上将 Pass@1 从 41.8% 提升至 56.4%,绝对提升 14.6 个百分点。
不过,这些数字来自微软研究院的实验设置和自测,目前不应被理解为所有生产环境都能获得同样幅度的改善。相关结果还需要独立复现,并与不同 harness、数据集和计算预算下的基线进行比较。
训练框架为何需要理解智能体的“外壳”
传统的智能体强化学习通常假定训练框架拥有完整的环境交互循环。模型生成动作,环境返回观察结果,训练系统把新的上下文拼回去,再要求模型生成下一步动作。对于早期的 ReAct 式智能体,这种方式相对直接。
但今天的编码、搜索和电脑操作智能体,往往由更复杂的 harness 驱动。它们负责上下文压缩、工具协议、子智能体调度、代码执行、权限控制和失败后的重新规划。OpenHands、OpenCode、Claude Code、Codex 以及其他框架的运行方式并不相同。如果为了训练而重新实现一套交互循环,训练中的对象就可能已经不是实际部署的智能体。
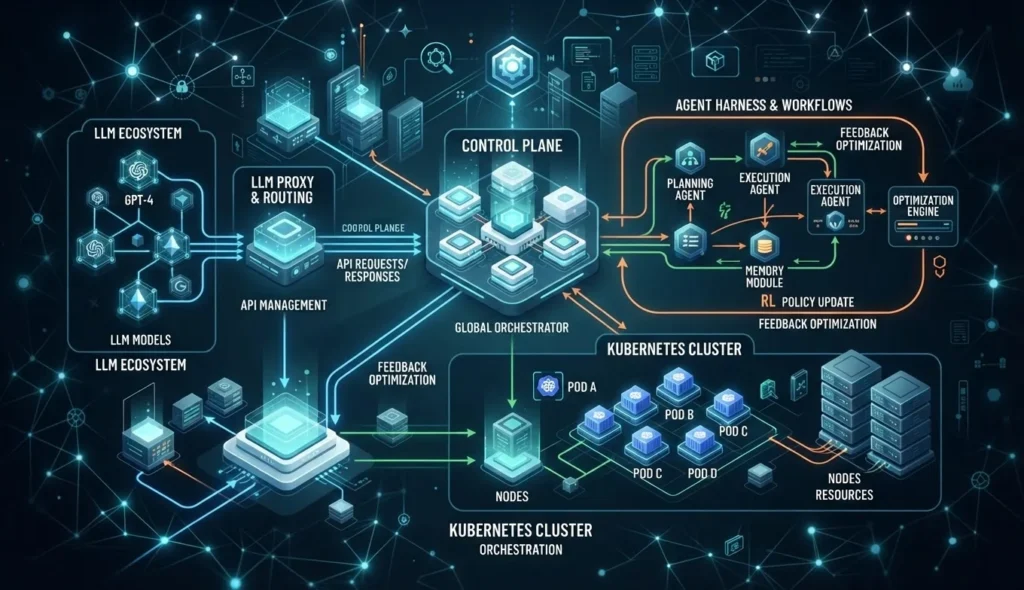
Agent Lightning 的做法是把一个 LLM proxy 放在智能体与模型之间。开发者通常只需把原来调用模型 API 的端点指向 Agent Lightning,智能体就能继续使用自己的工具、上下文和控制逻辑;训练系统则记录模型请求、响应、概率信息和对应的 rollout。
这也是“Harnessed Agentic RL”的核心含义:部署时使用的 harness,同时也是强化学习过程中的 harness。环境交互循环由智能体本身掌握,训练器观察的是一系列模型请求与响应,而不是强行接管所有动作。
轻量控制平面与 Kubernetes 支持
微软研究院将 v1.0 的系统拆成三个主要部分。API Gateway 负责提供兼容 OpenAI 的模型代理,并保存 rollout、模型调用和事件;Rollout Controller 负责启动和管理智能体,可以在本地运行,也可以把智能体作为标准 Kubernetes Job 调度;Customized Trainer 则基于 verl,负责收集 rollout、组装训练样本和更新策略模型。
这一设计使智能体运行与训练器保持分离。Agent Lightning 不要求使用付费的商业沙箱服务,开发者可以在自建集群、云端 Kubernetes 或本地基础设施上并行启动智能体。对于需要大量运行代码、浏览器或工具任务的训练流程,这意味着团队可以复用已有的计算资源和权限边界,而不是为每次 rollout 额外购买托管执行环境。
项目还介绍了“Collocated Async RL”机制。同步强化学习需要等待一批任务中最慢的智能体,可能造成 GPU 空闲;完全异步的方案则通常需要把 rollout 和训练分配到不同的 GPU 池。Agent Lightning 让两类工作共享 GPU,并在积累足够 rollout 后暂停新的请求,等待进行中的请求完成,再执行模型更新。微软研究院称,在其测试中,这种方式相较同步强化学习取得了约两倍的端到端速度提升,同时使用的 GPU 少于传统异步方案。
真实 harness 也带来新的训练难题
让训练系统观察真实智能体,并不只是把 API 接口换个地址那么简单。一个 harness 可能在一次任务中发出数量不固定的模型请求,也可能使用子智能体、上下文摘要或多轮工具调用。因此,一条 rollout 往往会被拆成多个训练样本。
首先是重新分词和样本合并问题。harness 通常以文本保存上下文,但强化学习需要使用 rollout 时实际生成的 token ID。重新套用聊天模板和 tokenizer,可能导致 token 边界发生变化,进而影响相邻请求是否能够合并。
其次是 advantage 计算和损失归一化。若直接按照样本级别计算,产生更多请求的 rollout 可能被重复计权;如果按照样本数量平均损失,也可能让 harness 的行为改变不同 rollout 对训练的影响。训练后端还必须把运行结束后才知道的样本数量和长度,映射到预先固定的 GPU 及并行配置上。
Agent Lightning v1.0 将这些问题作为框架的一部分处理,而不是假设所有智能体都拥有统一的单轮轨迹。这种工程取向与近期强化学习环境生态的发展方向相呼应:Hugging Face 已经开始把 RL 环境作为可版本控制、可发现的数据集资产管理,但任务运行时、验证器和奖励逻辑仍需由具体框架负责;AWS 的多轮强化学习实践也显示,智能体的完整检索轨迹比单次回答更接近真实任务的成功标准。
SWE-bench 结果说明了什么
微软研究院公布的编码示例使用 SWE-smith、mini-SWE-agent 和 Qwen3.5-9B,覆盖数据清洗、环境构建、奖励投机防护和强化学习训练。研究团队称,约 6,000 个样本和相对有限的计算资源,足以把 Qwen3.5-9B 在 SWE-bench Verified 上的 Pass@1 从 41.8% 提高到 56.4%。
这个结果的意义不只是模型分数上升,也在于训练过程保留了编码智能体的真实运行路径。智能体需要在代码仓库中理解问题、调用工具、修改文件并运行测试,奖励最终与任务是否完成相关,而非只针对某个孤立的模型输出。
但该结果仍有几个限制。第一,Pass@1 反映的是特定模型、harness、任务筛选和评估流程下的表现,不能直接外推到其他编码代理。第二,微软研究院的公告没有提供同等细节的独立第三方复现实验。第三,代码任务中的测试通过并不等同于所有真实软件工程场景都能稳定完成,尤其不能替代对权限、依赖、回滚和代码审查的治理。
因此,14.6 个百分点更准确地说是微软研究院在一套公开实验管线中报告的绝对提升,而不是 Agent Lightning 在生产环境中的普遍承诺。
开源项目把重点放在可复现性上
Agent Lightning v1.0 已在 Microsoft 的 GitHub 仓库发布,采用 MIT 许可证。仓库提供安装、快速开始、训练器配置、API Gateway、Rollout Controller、本地运行和 Kubernetes 运行示例,也包含 Search R1、LLM-in-Sandbox、ScienceWorld 和编码智能体等方向的示例。
微软研究院同时发布了 Agent Lightning v1.0 技术报告,报告介绍了 Harnessed Agentic RL 的定义、重新分词、样本合并、优势计算、损失归一化和后端调度等问题。该报告在 arXiv 上的提交日期为 2026 年 8 月 18 日,而此次新闻稿和开源版本发布于 10 月 7 日;前者是研究报告的时间,后者是 v1.0 公告的时间,两者不应混为一次同日发布。
Agent Lightning 的价值,最终取决于它能否让更多团队在自己的智能体和环境中复现结果。对于开发者来说,低代码量、OpenAI API 兼容代理和 Kubernetes 调度降低了接入门槛;但训练数据、奖励函数、验证器、执行权限和计算成本仍然需要自行设计。
这也意味着,智能体强化学习的竞争焦点正在从“能否让模型生成更好的下一句话”,转向“能否在真实工具和环境中持续完成任务”。Agent Lightning v1.0 提供了一条把部署时的智能体行为带回训练环节的路径,但它能否成为稳定的生产基础设施,还需要更多跨框架、跨模型和独立评测来回答。