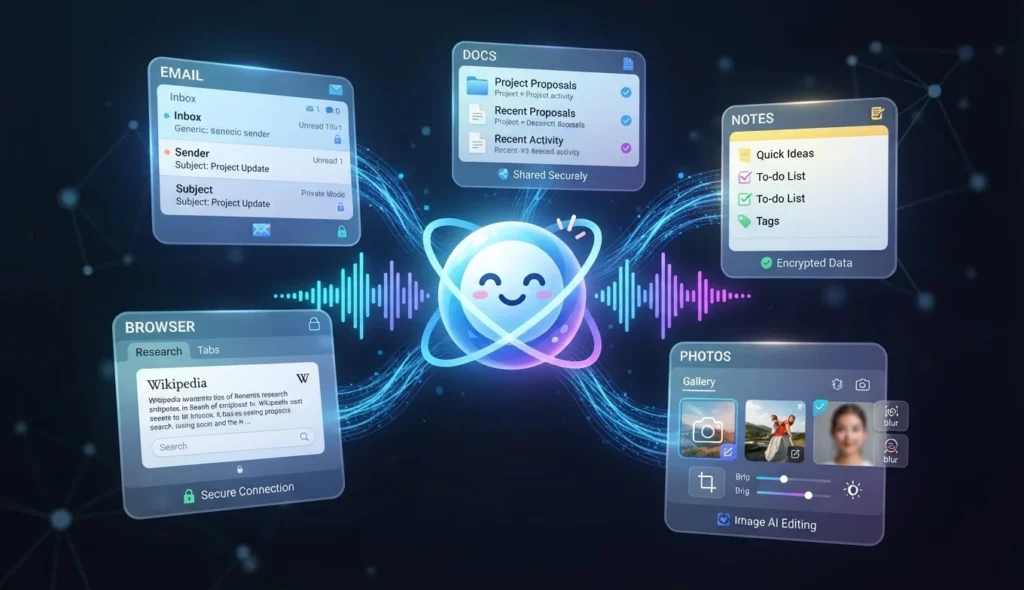
谷歌将 Google AI 订阅从单一聊天工具扩展为覆盖 Gmail、Docs、Keep、Workspace、Chrome 和 Photos 的跨应用 AI 能力,包括语音操作、Google Pics 图像生成与编辑,以及 Gemini Spark 的网页和相册辅助。功能按 AI Plus/Pro/Ultra 层级、地区与账户类型分阶段推出,谷歌强调权限与用户确认以控制风险。
谷歌正在把 Google AI 订阅从单一的聊天工具,扩展为覆盖办公、创意和日常网页任务的产品组合。9 月 9 日,谷歌公布 Google AI 计划的一组新更新,包括在 Gmail、Google Docs 和 Google Keep 中使用语音完成检索与内容整理,在 Google Workspace 中使用 Google Pics 生成和编辑图片,以及让 Gemini Spark 连接 Chrome 和 Google Photos,协助用户处理网页事务和相册整理。
这些功能并非全部面向所有用户开放。谷歌仍按 AI Plus、AI Pro 和 AI Ultra 等订阅层级、地区及账户类型分批推出,其中部分功能目前只在美国提供。更新显示,谷歌正试图把 Gemini 从“回答问题的助手”推进为嵌入既有软件、能够理解用户目标并协助完成任务的工作界面。
语音开始成为 Gmail、Docs 和 Keep 的操作入口
谷歌此次首先强调的是语音能力。用户可以在 Gmail、Docs 和 Keep 中直接说出自己的需求,用语音查询收件箱、口述文档内容,或把零散想法整理成笔记和清单。
根据谷歌的官方介绍,这项能力在 Gmail 和 Keep 中面向 AI Plus、Pro 和 Ultra 用户提供,在 Docs 中则面向 AI Pro 和 Ultra 用户提供。谷歌此前在 5 月发布的Workspace 更新公告中,曾将这些功能分别称为 Gmail Live、Docs Live 和 Keep Live。
在 Gmail 中,用户可以通过自然语言询问邮件里的具体信息,例如航班登机口或孩子学校本周的安排。系统会从收件箱相关邮件中提取信息并组织答案,而不是要求用户先输入精确关键词。
Docs Live 的目标更接近写作协作。用户可以直接口述一段尚未整理的想法,让 Gemini 协助搭建结构、形成大纲、调整语气并生成初稿。按照谷歌的说法,在获得用户许可后,系统还可以从 Gmail、Drive、Chat 和网络中提取相关资料。
Keep Live 则面向更短、更零散的记录。用户可以连续说出待办事项、购物需求或突然想到的内容,Keep 会尝试将其整理成笔记、列表和提醒。
AIFlux此前在谷歌把语音带进 Gmail、Docs 和 Keep中指出,这些功能的变化不只是把键盘输入换成麦克风,而是让用户先说出目标,再由应用完成检索、结构化和初步编辑。
不过,语音交互降低操作门槛,也会带来新的准确性和权限问题。转录错误可能改变用户原本的意思;当系统同时访问邮件、云端文件和聊天记录时,用户需要了解答案来自哪些资料。谷歌目前强调分阶段推出,并对资料访问设置用户许可,这意味着它仍在测试功能边界,而不是把所有办公任务交给模型自动完成。
Google Pics 将图像生成放进 Workspace 工作流
第二项更新是 Google Pics。谷歌称,用户可以在 Google Workspace 中用它设计海报、制作社交媒体内容或编辑数字插图,相关能力面向 AI Pro 和 Ultra 用户提供。
Google Pics 并不只强调从提示词生成一张新图片。根据谷歌 9 月 1 日发布的产品介绍,它还支持对象分割、局部修改、图片文字编辑和多次生成。用户可以选中图片中的某个对象进行调整,也可以直接修改或翻译图片里的文字,同时尽量保留原有设计和字体效果。
谷歌表示,Google Pics 基于 Nano Banana 图像生成和编辑模型构建,既可以作为独立工具使用,也计划逐步整合进 Slides、Docs 和 Drive。这样一来,用户不必先在独立图像工具中完成创作,再把素材下载、上传到 Workspace;图片可以更直接地进入演示、文档和团队协作流程。
Google Pics上线:谷歌把AI图像生成与精准编辑带进Workspace曾提到,谷歌试图把图像模型从“生成一张好看的图片”推进到“修改一张正在使用的图片”。这对市场营销、教育、销售演示和小型团队更为实际,因为这些用户通常需要的是能快速调整、马上放进文档或演示文稿的视觉素材。
但“进入 Workspace”并不等于所有用户立即可用。Google Pics 仍会受到订阅层级、地区、账户类型及管理员设置影响。图像文字是否足够准确、对象级编辑在复杂场景中是否稳定,以及多人协作中的版本管理是否清晰,都仍需要在更广泛的实际使用中验证。
Gemini Spark 连接 Chrome 和 Google Photos
谷歌还表示,Gemini Spark 现在与 Google Chrome 和 Google Photos 连接。对于美国的 AI Pro 和 Ultra 用户,Spark 可以协助处理网页事务、编辑照片或整理相册。
这条路线延续了谷歌对代理式助手的尝试。此前,谷歌曾介绍 Gemini Spark 在用户授权后协助推进网页任务,例如安排看房时间或推进机票预订流程。涉及支付等高风险环节时,谷歌表示仍会要求用户确认,并为提示注入等风险增加防护。
AIFlux在Gemini Spark 接入 Chrome的报道中指出,谷歌并没有把 Spark 描述成一个可以完全替用户点击网页的自动机器人,而是试图在重复操作与人工确认之间建立一个半自动层。此次把 Chrome 与 Photos 纳入 Google AI 计划,意味着这类能力开始从独立的 Gemini 产品扩展到浏览器和个人内容管理场景。
不过,这也是此次更新中风险边界最需要关注的部分。浏览器任务可能涉及登录状态、个人资料、已保存密码、预订信息甚至付款。用户是否清楚模型正在读取哪些页面、哪些步骤由模型执行、哪些操作必须由人确认,将直接影响这类功能能否进入日常使用。
订阅计划正在变成谷歌的产品分发层
谷歌此次还宣布,全球符合条件的大学生可以免费获得一年的 Google AI 计划。结合语音办公、图像编辑和网页代办等更新来看,AI 订阅正在从“获得更强模型的套餐”,转变为一套跨应用的产品分发机制。
用户购买的并不只是 Gemini 对话窗口的更高使用额度,还包括 Gmail、Docs、Keep、Workspace、Chrome 和 Photos 中逐步增加的 AI 能力。对谷歌而言,这种模式可以把 Gemini 放进用户原本已经形成的工作和生活流程;对用户而言,价值则取决于这些功能是否真的减少了切换应用、检索资料和重复编辑的成本。
谷歌在此前发布的Workspace公告中称,超过 40 亿用户依赖 Gmail、Docs 和 Drive 等 Workspace 应用。这个庞大的分发基础,是谷歌把 AI 直接嵌入办公软件的主要优势。但规模也意味着更高的可靠性要求:当 AI 从生成建议逐渐走向检索个人信息、修改文件和推进网页任务时,准确性、数据边界、人工确认和企业管理员控制都不能只停留在产品演示层面。
目前可以确认的是,谷歌正在把同一套 Gemini 能力铺向更多应用,并按照订阅层级和地区逐步开放。至于这些功能能否从“可用”变成真正可靠的生产力工具,还要看它们在真实工作流中的准确率、权限透明度以及用户是否愿意长期把部分日常任务交给模型。