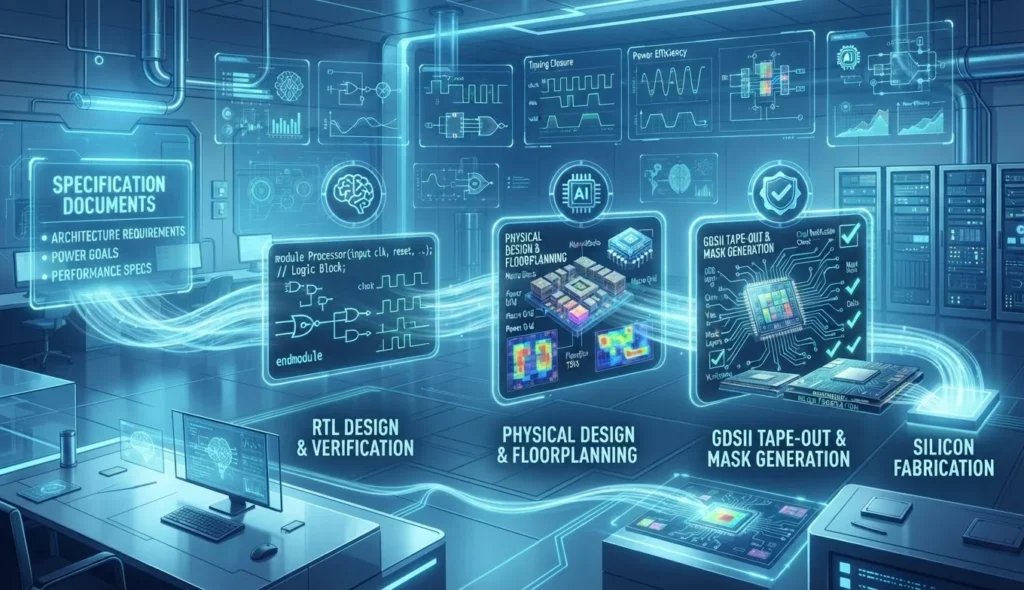
ChipAgents与英伟达联合推出 Build-A-Chip-Bench,提出从规格到GDS的端到端芯片设计评测基准,旨在衡量智能体在完整物理实现、时序与功耗约束下的工程能力。初步结果显示智能体能通过部分功能验证,但仅有少数任务同时满足物理与PPA约束,主要挑战在于跨阶段回溯早期设计决策与长时工具循环。
ChipAgents与英伟达公布了一项新的芯片设计评测基准,试图把人工智能智能体的能力测试从局部代码生成,推进到完整的数字芯片设计流程。
ChipAgents于2026年10月14日在其新闻稿中宣布推出 Build-A-Chip-Bench。该基准要求受测智能体从工作负载规格和接口约束出发,完成架构、微架构、RTL设计、功能验证、逻辑综合、布局规划、布局布线、时序与功耗签核以及物理验证,最终生成经过验证的GDS版图。
不过,ChipAgents公开的初步结果也显示,智能体在芯片工程中最难跨越的部分,仍然不是“能否写出可以运行的RTL”,而是能否让早期设计决策经受后续物理实现、时序、功耗和面积约束的反复检验。
新基准试图补上芯片智能体评测的下游空白
过去的芯片设计基准通常聚焦于某一个环节,例如根据规格生成RTL,或对既有代码进行验证。ChipAgents在研究页面中称,VerilogEval、CVDP和ChipBench等基准推动了硬件智能体的发展,但它们大多属于“点测试”:智能体完成RTL或验证任务后,评测便告结束。
Build-A-Chip-Bench的设计则覆盖从工作负载规格到GDS版图的完整路径。一个任务可能依次经过工作负载定义、架构、微架构、RTL、功能验证、综合、floorplanning、placement、时钟树综合、布线、签核和物理验证等阶段。
这一区别很重要。RTL在仿真中功能正确,并不意味着它能够在真实的物理设计流程中满足目标。布局布线可能暴露拥塞问题,签核可能出现时序违例,设计也可能超出面积或功耗预算。问题甚至可能追溯到数十小时前作出的微架构、流水线或存储划分决定。
因此,新的基准不仅要看智能体是否产生了正确代码,还要看它能否读取综合、时序、拥塞和设计规则检查报告,并在必要时回到前面的架构或RTL阶段修改方案。
通过硬门槛后,才开始比较PPA
Build-A-Chip-Bench采用分阶段评分。首先,设计必须通过隐藏的功能验证IP;其次,它需要生成能够完成物理流程的GDS版图,并满足可布线、保持时间和设计规则检查等要求。只有同时通过功能和GDS门槛的设计,才会进入功耗、性能和面积,也就是PPA评估。
研究页面给出的示例任务,是为一个固定的 Qwen3-0.6B INT4 检查点构建推理加速器,并完成从设计到GDS的流程。任务卡要求设计满足400MHz时钟目标、面积不超过6平方毫米、功耗低于10瓦、解码吞吐量至少达到每秒15个令牌,同时做到零设计规则错误和零未布线网络。
ChipAgents给出的一个参考设计达到每秒16.35个解码令牌,面积为5.76平方毫米,功耗为136.2毫瓦,setup WNS为正0.131纳秒,并通过了56项隐藏提示测试。不过,这属于任务中的参考设计结果,并不是受测模型的成绩。
在公开的模型评测表中,Claude Fable 5.1的功能通过率为65%,GDS通过率为75%,通过双重门槛后的PPA约束得分为25.5%,最终总分为16.6%。GPT-6 Astra的功能通过率和GDS通过率均为85%,但最终总分为8.7%;Gemini 3.8 Flash、Kimi K3和GLM-5.3的总分则分别为0.8%、0.2%和0%。
这些指标不能简单理解为“功能通过率越高,整体芯片设计能力越强”。按照研究方的评分规则,只要设计未通过其中一个硬门槛,该任务的PPA得分便为零。这样做的目的,是避免智能体在少数任务上取得较好的面积或性能,却掩盖其无法稳定完成整个流程的问题。
ChipAgents的新闻稿还给出了更概括的初步结果:受测智能体平均约有40%的任务通过功能验证,但只有约10%的任务同时满足物理性能、功耗和面积目标。相关结果来自ChipAgents及其合作方的公开评测,目前尚未有独立第三方复测。
智能体会运行工具,但还不擅长回溯早期决策
研究页面把当前智能体的困难归纳为几个方面。
第一,智能体需要在时间预算内形成足够可靠的工程判断。综合和布局布线通常需要较长时间,单次运行可能持续数小时。智能体不能无限尝试不同的利用率、时钟和布线参数,而必须较早判断流水线深度、面积预算和时钟规划是否合理。
第二,智能体需要处理跨阶段反馈。一个在签核阶段出现的时序问题,可能源自微架构中的流水线选择;一个布线拥塞问题,可能源自更早的floorplan或SRAM划分。研究方观察到,当前智能体往往首先在物理设计层面反复调整参数,而不是及时回到RTL或架构层面改变根本原因。
第三,优化本身可能破坏已经正确的设计。研究页面记录的一次运行中,智能体重写数据通路以追求更高吞吐量,却引入了功能错误和执行挂起。经过修复后,最终结果反而比原始设计慢约3%。这说明智能体还没有稳定地把“保持已有行为正确”作为优化过程中的硬约束。
第四,慢速工具循环会影响收敛。智能体在软件开发中形成的快速尝试习惯,未必适用于需要数小时才能获得反馈的物理设计流程。一个没有充分规划的布局布线运行,可能在时间预算耗尽前仍未完成,迫使智能体放弃一次尝试,却没有得到足够有用的反馈。
这也解释了为什么端到端基准比单独的RTL生成更接近真实芯片工程:它要求智能体处理工具链、状态、时间、物理约束和跨阶段因果关系,而不只是完成一次代码生成任务。
英伟达的合作重点不只是一个排行榜
英伟达新闻室的公告确认,ChipAgents正在使用英伟达的AI基础设施、模型训练和优化软件开发芯片设计专用模型,双方也在共同开发Build-A-Chip Bench。英伟达将其描述为衡量智能体从规格到图形数据系统,也就是GDS,完成端到端工作流能力的基准。
这项合作被放在英伟达更大的“AI定义晶圆厂”叙事中。同期公告还介绍了cuPotential、cuEST、cuDSS、NanoVDB以及NPP等用于材料模拟、工程求解、三维数据处理和检测的工具,并列举了Synopsys、Cadence、Lam Research、KLA和其他半导体企业的采用案例。
其中,cuPotential处于早期访问阶段。英伟达称,在早期测试中,它让已经过GPU优化的工作流额外提速约2至3倍;Synopsys披露的QuantumATK和S-Device加速数字,则分别属于cuEST和cuDSS的特定测试场景,不能直接当作Build-A-Chip-Bench的结果,也不能等同于整个晶圆厂的统一效率提升。
英伟达正在推进的方向,是让智能体能够调用模拟器、求解器、图像处理库和EDA工具,而不是只依赖语言模型预测一段代码。对于芯片设计而言,专业工具提供的仿真、时序、物理验证和检测结果,才是智能体能否继续行动的重要反馈。
在这一点上,AIFlux此前关于英伟达推出cuPotential并将CUDA-X带入芯片设计与制造流程的报道提供了一个相邻背景:当AI进入半导体工程,竞争焦点正在从模型本身扩展到模型能否稳定编排专业工具和计算流程。
从单次生成到长期工程闭环
Build-A-Chip-Bench也与Synopsys近期把智能体纳入EDA流程的尝试形成呼应。AIFlux此前报道的Synopsys AgentEngineer与Autopilot平台同样强调长期运行、工具调用、记忆和工程治理,而非单次代码生成。
两者关注的层面不同。Synopsys的产品路线更接近企业EDA工具链和长期工程工作流;Build-A-Chip-Bench则试图为不同智能体提供共同的、可重复的端到端评测环境。但它们都指向同一个转变:AI在工程领域的价值,越来越取决于能否在明确约束下持续工作,并对自己的中间结果负责。
ChipAgents表示,未来将与产业合作伙伴推出实时排行榜,扩大任务范围并覆盖更多前沿模型。研究页面列出的合作方包括Analog Devices、MediaTek和NVIDIA,但目前公开结果仍属于早期评测,任务数量、模型配置、运行成本和评测条件都需要在后续版本中进一步说明。
基准更严格,并不意味着量产芯片已经可以由AI独立完成
Build-A-Chip-Bench的意义,在于它把芯片智能体的能力边界放到了更接近实际工程的位置:功能正确只是起点,版图能否布通、时序能否收敛、功耗和面积能否达标,以及优化是否会破坏原有行为,才决定设计能否继续向下游推进。
但这项基准也不应被解读为AI已经能够自主完成量产芯片设计。首先,公开结果来自基准创建方及其合作方,尚未经过独立第三方复测。其次,测试使用了指定的沙箱、开源工具和开源PDK,结果能否迁移到商业EDA工具、先进制程和大型生产项目,仍然未知。再次,基准通过率和总分衡量的是特定任务环境中的智能体能力,不等同于一个芯片项目可以脱离工程师、供应链和制造验证独立完成。
更值得关注的问题,是未来的智能体能否在发现下游失败后,稳定地回到上游重做架构决策;能否在提升PPA的同时保持功能等价;以及能否在长时间运行、调用专有工具和访问敏感设计数据时接受权限控制、审计和人工审批。
Build-A-Chip-Bench首先提供的,可能不是一个证明AI已经实现芯片设计自动化的答案,而是一条更清楚地展示差距的测量尺。按照目前的结果,智能体已经能够在部分任务中走完整条流程,但距离稳定、可重复并满足真实工程约束的自主芯片设计,仍有明显距离。
来源:
- ChipAgents新闻稿:ChipAgents Collaborates With NVIDIA to Launch Build-A-Chip-Bench for Autonomous Chip Design and Implementation
- ChipAgents研究:Introducing Build-A-Chip-Bench: from workload specification to GDS
- NVIDIA Newsroom:NVIDIA and Semiconductor Leaders Advance AI Across Chip Design and Manufacturing for AI-Defined Fabs
- NVIDIA投资者关系页面:NVIDIA and Semiconductor Leaders Advance AI Across Chip Design and Manufacturing for AI-Defined Fabs