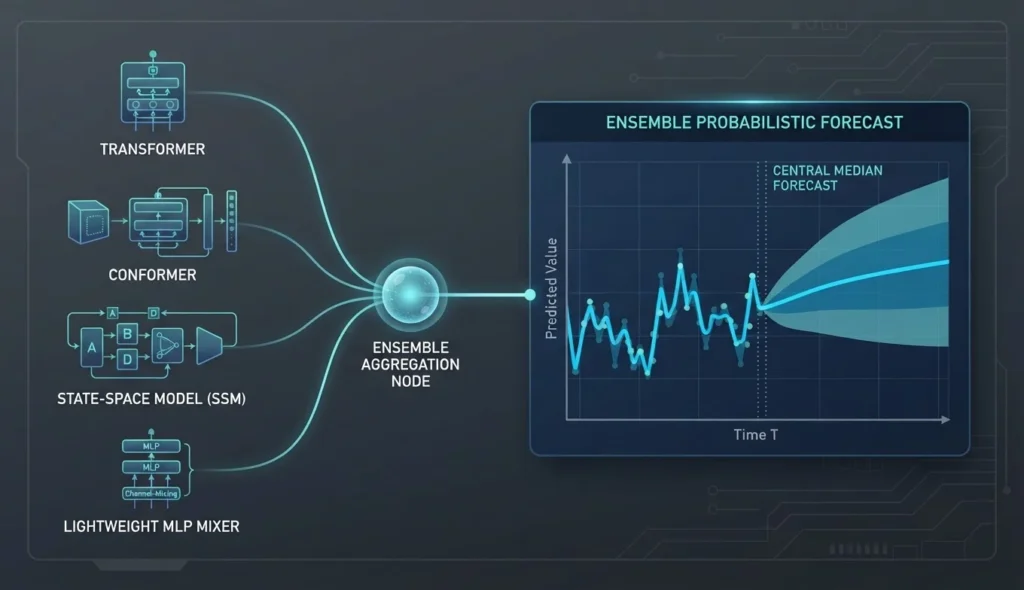
IBM Research 介绍了 Granite Timeseries Ensemble R1,将四种不同架构的预训练时间序列模型在不重训练、不拟合权重的前提下组合为统一预测接口,提供等权概率与基于IQR的自适应加权两种聚合方法。评测显示集成在单点预测上有小幅改进,但在概率预测误差上并非全面领先,部署仍需权衡推理成本、校准与多变量限制。
IBM Research在2026年10月22日发表技术文章,介绍如何将四个采用不同架构的Granite时间序列模型组合起来,在不重新训练模型、不拟合集成权重的情况下,输出单点预测及反映不确定性的分位数预测。
这套名为Granite Timeseries Ensemble R1的方案,试图解决预训练预测模型落地时的一个实际问题:模型可以直接处理新数据,但开发者仍要判断,哪一种架构最适合自己的业务。IBM给出的答案不是再训练一个更大的模型,而是提供一个统一的组合方案,让多个模型共同参与预测。
不过,IBM公布的结果也划清了它的能力边界:集成方案在综合单点预测误差上略优于最强的成员模型,但概率预测误差并非全面领先。它更适合作为减少选型试错的起点,而不是无需验证的通用赢家。
这次介绍的是组合方法,不是四个新模型
根据IBM Research的原始文章,默认组合包含PatchTST-FM-r1、PatchTST-FM-r2、FlowState-r1.1和TTM-r3,分别采用分片Transformer、分片Conformer、状态空间模型和轻量级MLP混合器架构。
这些模型处理趋势、季节性和局部变化的方式不同。组合它们的理由是:不同模型可能在不同场景下出错,而这些错误未必完全重合。相较于事先押注某一个模型,综合多个预测有机会降低选错架构的风险。
其中,PatchTST-FM-r2并不是本次才出现的模型。本站在9月的相关报道中,已介绍它用Conformer模块结合注意力机制与卷积的设计。本次文章的重点,是如何把这类不同架构放进同一套预测接口。
时间上也需要区分:10月22日是技术文章的发表日期,不能直接当作集成方案首次公开的日期。其官方模型卡已经列出9月28日的评测快照,说明这套方案在本次文章发表前就已存在。
模型仓库存放的也不是把四套权重合并后得到的一个新模型,而是可复用的集成配置。运行时,系统仍需从各自的仓库下载并加载成员模型。因此,“无需重新训练”并不意味着只需运行一个模型,也不意味着没有额外的计算成本。
等权组合与自适应加权,分别相信什么
IBM提供了两种主要聚合方法,推荐首先尝试的是Probabilistic Ensemble,即等权概率池化。
按照官方说明,这种方法让每个成员具有同等影响,将成员输出的分位数预测在概率空间中汇集,再提取所需的分位数。它并不是简单地把四个单点预测取平均,也不需要根据新业务的历史误差学习一组权重。
默认配置输出从0.1到0.9的九个分位数,并以0.5分位数,也就是中位数,作为单点预测。对于库存或能源调度等场景,使用者因此不仅能获得一个中心估计,也能观察预测分布的上下范围。
例如,0.1与0.9分位数构成名义覆盖率为80%的中央预测区间。但“名义80%”不是已经验证的可靠性承诺:真实观测值是否确实有相应比例落在区间内,仍要用业务数据检验。
第二种方法是IQR Ensemble,即基于四分位距的自适应加权。它利用接近第25和第75百分位的可用分位数,估计每个成员预测的离散程度;预测区间越窄,成员获得的权重越大。权重可以随样本、预测目标和未来时间步变化,但同样不是根据历史预测误差拟合出来的。
这一方法隐含的判断是,模型给出的分布宽度能够提供有用信息。然而,区间更窄也可能只是模型更自信,并不代表它更准确。IBM因此明确提醒,IQR加权可能偏向过度自信的成员。实现中的保序回归可以防止输出分位数交叉,却不能自动解决概率校准问题。
组合预测本身并不是新概念。Wang、Hyndman等人的《预测组合:逾50年研究回顾》讨论了从简单组合到时变权重、非线性组合及概率预测组合的发展。Granite这次选择的重点,是把无需拟合权重的组合方法做成可直接调用的零样本预测方案,而不是证明某一种组合规则对所有数据都有效。
评测显示小幅单点收益,概率误差仍有取舍
IBM文章采用2026年10月20日的GIFT-Eval排行榜快照,比较两种集成方法与四个成员模型,覆盖97个数据集配置。按照IBM的说明,模型没有针对这些任务进行微调,测试目标也未被用于选择或拟合聚合方法。
GIFT-Eval官方仓库确认,标准结果文件包含97个数据集配置。下表中的具体分数则来自IBM文章披露的比较,不应理解为本文进行了独立复测。
| 预测方案 | 综合MASE,越低越好 | 概率预测误差CRPS/MWQL,越低越好 |
|---|---|---|
| 等权概率集成 | 0.683 | 0.471 |
| IQR集成 | 0.684 | 0.471 |
| PatchTST-FM-r2 | 0.685 | 0.467 |
| FlowState-r1.1 | 0.701 | 0.490 |
| PatchTST-FM-r1 | 0.717 | 0.488 |
| TTM-r3 | 0.724 | 0.520 |
MASE,即平均绝对缩放误差,用于衡量单点预测表现。文章将GIFT-Eval的平均加权分位数损失指标记为CRPS/MWQL,用于比较概率预测误差。这些综合分数经过相对季节性朴素预测的归一化,并在各配置间取几何平均。
结果支持一个有限但明确的结论:两种集成方法的综合MASE都优于四个单独成员,但相对最强成员PatchTST-FM-r2的领先幅度很小。等权概率集成得到0.683,PatchTST-FM-r2为0.685,不能据此宣称准确率出现大幅跃升。
概率预测方面,PatchTST-FM-r2的综合误差仍然最低,为0.467,优于两种集成方法显示的0.471。IQR集成则在这六种方案的平均概率误差排名上表现最好。这并不矛盾:综合误差衡量的是误差大小,平均排名衡量的是各配置中的相对位置,两者可能支持不同选择。
“排名第三”的说法也有前提。IBM文章称,在其10月20日比较中,集成方案在MASE平均排名和概率误差平均排名两个维度进入符合条件系统的第三位;但比较对象经过筛选,排除了微调条目、已知采用非宽松许可或依赖此类成员的系统等。这不是完整排行榜上的无条件第三,更不是所有指标的第一。
此外,模型卡使用的是9月28日快照,其部分数值和名次与10月文章不同。不同日期的排名不能拼接使用,也不宜把某一次快照中的位置视为永久结论。
省下选型工作,也要支付四模型推理成本
对于工程团队,这套方案的直接价值是提供统一接口和可调整的成员配置。官方模型卡说明,兼容的外部预测器可以通过实现共同的Forecaster接口接入,前提是输出形状和分位数水平符合要求。开发者因此可以改变模型组合或聚合规则,而不必合并成员权重。
但这一便利有明确成本。加载四个检查点会增加内存占用和推理时间;各成员对历史窗口长度、预测跨度、预处理和缺失值的处理方式也不完全一致。究竟增加多少资源开销,需要结合实际工作负载测量,现有材料不能替代部署测试。
还有一项容易被忽视的限制:当前方案对多变量数据的各通道独立预测,不利用跨通道信息。换言之,把销量、价格和其他变量一起输入,并不意味着它会自动学习这些变量之间的关系。对于依赖跨变量信息的任务,这一边界应在选型时就加以考虑。
许可也需要逐层检查。官方模型卡将集成配置和Granite TSFM实现列为Apache-2.0许可,默认组合使用宽松许可的Granite检查点,但成员权重仍受各自仓库条款约束。可选的扩展组合还会引入另有许可条件的IBM Research检查点,其中可能包含非商业或研究用途限制,不能因为默认组合允许较宽松使用,就推定所有扩展方案都相同。
真正要验证的,是组合是否适合自己的数据
IBM建议先从等权概率集成开始,再把IQR方法和表现较强的单模型放到相同历史窗口中回测。这样的比较应尽可能还原每次预测时实际可获得的数据,而不是让模型提前看到未来信息。
评估也不应只盯着一个误差分数。除了比较MASE和分位数损失,还需要检查预测区间的实际覆盖率,并记录延迟、内存和计算成本。如果四模型组合只带来很小的误差改善,却显著增加服务开销,单模型仍可能是更合适的选择。
同样重要的是上线后的持续监测。IBM明确表示,两种聚合方法都不能保证在数据分布变化时保持可靠,也不保证预测区间已经校准。
因此,Granite Timeseries Ensemble R1的意义,不是终结时间序列模型选型,而是把“先选定一个架构”改为“先测试一个可解释、无需拟合权重的组合基线”。它是否值得采用,最终仍取决于企业自己的数据、预测跨度,以及愿意为有限精度收益承担多少推理成本。