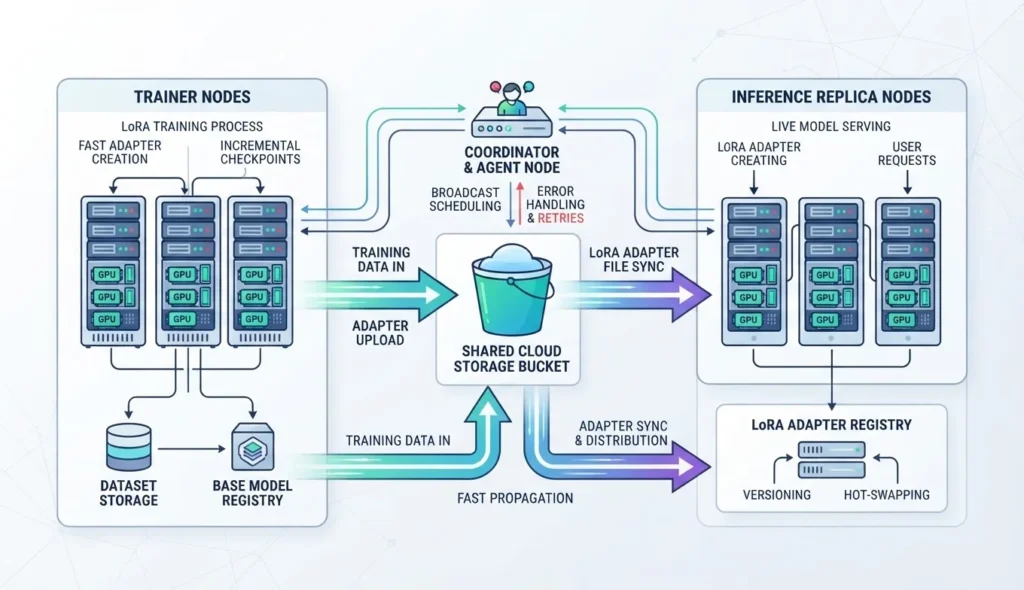
Hugging Face 在 2026 年展示了基于 Jobs、Storage Buckets 与代理服务的 LoRA 异步 GRPO 流水线,通过仅同步小体积适配器文件替代跨 Job 的 NCCL 权重同步,将 500 步训练时间从 3 小时 27 分钟缩短至 53 分钟,但加速结果受副本数量和样本总量变化影响,不能直接类比相同资源下的性能。
Hugging Face 在 2026 年 9 月 10 日发布的技术文章中,介绍了利用 Hugging Face Jobs、Storage Buckets 和代理服务运行 LoRA 异步 GRPO 的方案。训练器与 vLLM 推理副本分别运行在不同机器上,通过存储桶共享适配器文件,无需使用 NCCL 进行跨 Job 的权重同步。
据文章披露,TRL v1.14 中的 AsyncGRPOTrainer 已支持 LoRA 训练及仅适配器同步。作者围绕同一模型和训练配方开展五轮实验,将 500 步训练的总耗时从 3 小时 27 分钟缩短至 53 分钟,报告约 3.9 倍加速。不过,最终配置增加了推理副本,实际训练样本数也有所增加,因此这一结果不能理解为相同资源、相同样本量下的性能对比。
从完整权重同步改为适配器同步
实验采用 Qwen/Qwen2.5-Math-1.5B,LoRA rank 为 1、alpha 为 2,作用于 all-linear 模块。文章指出,这一规模模型的完整权重约为 3 GB,而 rank-1 LoRA 适配器只有数 MB,使通过存储桶分发更新成为可行方案。
初始部署包含一个使用两张 H200 的训练 Job,以及两个各使用一张 H200 的 vLLM Job。所有 Job 将同一个 Storage Bucket 挂载到相同绝对路径。训练器每隔四个优化器步骤保存一个带版本号的适配器目录,再向 vLLM 的 /v1/load_lora_adapter 接口发送文件路径,由推理端从挂载目录读取文件。检查点和最终适配器也保存在存储桶中。
这一路径替代的是跨机器的适配器数据传输,并不意味着各组件无需网络连接。训练器内的代理仍通过 HTTPS 访问推理 Job,处理生成请求与适配器加载。
代理负责缓存路由和多副本一致性
代理运行在训练 Job 内,为发往公开 Job 端口的请求添加认证头,并将适配器加载、卸载及暂停、恢复操作广播给全部推理副本。
由于各副本的存储桶挂载可能在不同时间看到新文件,代理会对尚未发现适配器的副本重试;如果加载出现其他错误,则卸载已成功加载的副本上的对应适配器,避免同一策略名称只在部分副本上可用。
生成请求的分配同时考虑 KV 前缀缓存和负载。代理将提示词切分为 16-token 块,使用以适配器名称为种子的链式哈希追踪前缀归属,优先把相同提示词的多次采样发送给已有对应缓存的副本。如果该副本的在途请求数比最空闲副本多出超过 8 个,请求就转向负载较低的副本。
适配器使用独立版本名称,避免旧权重生成的 KV 缓存被新策略误用。在 max_staleness=4 的配置下,作者为 vLLM 设置了 6 个 LoRA 槽位,以容纳当前版本、允许滞后的版本,以及更新切换期间的新版本。
五轮实验定位训练与生成瓶颈
实验使用 sail/Sanity-Test-R1D-1.5B 数据集,包含 1,460 道筛选后的数学题,每个提示词生成 8 个样本。初始配置每步训练 128 个样本,最大生成长度为 3,000 tokens,上下文长度为 4,096 tokens。
第一轮的瓶颈在训练端:优化器步骤耗时中位数为 22.9 秒,其中前向和反向计算为 21.9 秒;采样队列接近满载,训练器几乎无需等待生成结果。每个 rank 每次只处理一条序列,导致微批次过小,报告的模型 FLOPs 利用率约为 3.9%。
第二轮启用 token-budget batching,将 token_budget 设为 16384、梯度累积步数设为 6。每行打包样本数从 1 增至约 12.7,微批次数从 64 降至 6,前向和反向计算耗时降至约 5.6 秒。实际每步处理样本数也增至约 150,因此这项调整并非严格保持每步样本数不变。
第三轮关闭梯度检查点,减少反向传播时的前向重算,使前向和反向计算进一步降至约 4.6 秒,瓶颈随之转向生成端。这一调整适用于文章中模型较小、显存充足的条件。
第四轮增加第三个推理副本,并缩短适配器加载重试间隔,但生成吞吐量只从约 2.5 万 tokens/秒升至约 2.6 万 tokens/秒。作者发现,max_inflight_tasks=128 限制的是整个采样工作进程的并发量,而非每个副本;增加 GPU 后,请求被分散,新增副本未得到充分利用。
第五轮将全局在途任务上限提高到 384,并把队列容量设为 768。生成结果重新填满队列,训练端再次成为瓶颈。最终配置完成 500 步训练用时 53 分钟,步骤耗时中位数为 4.8 秒,前向和反向计算耗时中位数为 4.6 秒,相关 MFU 指标为 23.5%。
加速结果的适用范围
按文章汇总,初始配置与最终配置分别训练了 64,000 和 84,078 个样本;平均样本滞后从 1.5 个策略版本增至 2.0 个,仍低于配置上限 4。两次运行最初 20 步的平均奖励均为 0.145,最后 20 步分别为 0.438 和 0.416。作者认为奖励曲线基本接近,但这不等于最终奖励完全相同。
初始双副本运行的 126 次同步共涉及 252 次适配器加载,全部成功,其中部分加载需要重试。作者还报告,训练与推理策略一致性相关的 ratio 指标保持在接近 1 的范围内。
文章将实现代码公开在 https://github.com/AmineDiro/hfjobs-lora-buckets 。其复现配置固定使用 vLLM v0.27.1,所需运行时 LoRA 接口与参数应结合该版本理解。对于 DoRA、modules_to_save 或超过推理端 rank 上限等无法直接服务的配置,文中指出训练器会发出警告并回退到合并权重同步,不能默认沿用仅适配器同步路径。