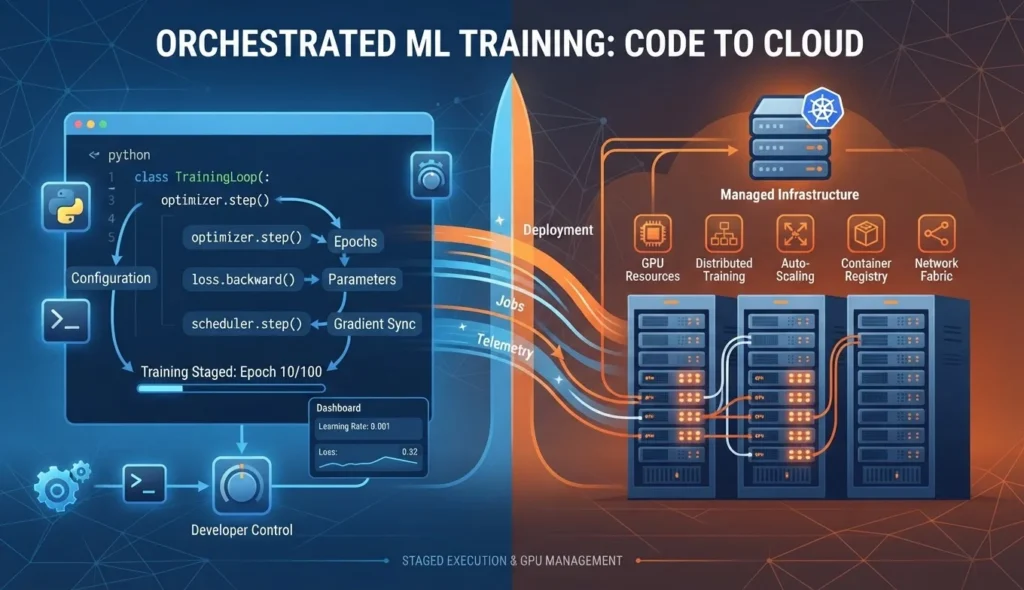
AWS 为 Amazon SageMaker 推出训练会话功能,允许开发者在 Python 中逐步编排训练循环(采样、前向/反向传播、优化步骤),同时将 GPU 分配、分布式执行与故障恢复交由平台管理。这项功能拓宽了托管微调与完整训练任务之间的控制边界,适合需要自定义奖励与训练阶段编排的多轮智能体和强化学习场景,但仍受模型、区域和并发配额等限制,且成本和安全责任仍由用户承担。
AWS宣布,Amazon SageMaker AI的训练会话(training sessions)正式可用。与只需提交数据、选择训练方法的高层托管接口不同,这项能力允许开发者用Python逐步编排模型训练:何时生成回答、如何计算奖励、何时计算梯度和更新权重,都可以由自己的程序决定;GPU分配、分布式执行、故障恢复和检查点存储则交给平台。
这次变化的重点不是让SageMaker首次支持强化学习,而是改变开发者与云服务之间的控制边界。AWS的发布公告明确指出,平台此前已经提供托管的多轮强化学习,新增训练会话是为了满足自定义损失函数、奖励信号和训练阶段编排的需求。
对于正在训练工具调用智能体或研究新对齐算法的团队,这意味着可以在不自行运营GPU集群的情况下,保留更多训练过程的决定权。但数据、奖励设计和任务评估并没有因此自动解决,服务也不是面向任意模型、任意区域的通用训练入口。
从提交训练任务,转向逐步调用训练操作
传统托管微调通常要求开发者事先提供数据和超参数,再由服务执行预设流程。如果研究者需要改变损失函数、调整数据课程,或把生成、工具调用和奖励评分交织在一起,固定流程就可能成为限制。另一种选择是自己提交完整训练脚本,但这通常意味着承担更多实例选择和分布式训练工作。
根据AWS配套技术说明,训练会话把抽象层下移到了单次操作:sample()负责生成模型响应,forward_backward()执行前向与反向传播、计算梯度,optim_step()应用优化器更新。开发者将这些操作组合成监督微调、强化学习或多阶段训练流程。
这些调用面向的是一个有状态会话。模型在调用之间保持加载,而不是每次操作都重新启动。服务负责分布式执行和梯度同步;开发者的Python进程则负责控制顺序、组织数据以及处理任务相关逻辑。
AWS将这项能力放在高层无服务器模型定制与完整训练任务之间:前者主要让用户选择既有方法,训练会话允许自行编排操作;若需要提交完整训练脚本或控制更多底层训练细节,SageMaker Training Jobs和HyperPod仍是不同的选择。操作级控制并不等于对所有底层框架和硬件配置拥有完全控制。
多轮智能体训练,为什么需要这种接口
一个搜索、编程或客服智能体往往需要连续采取多个行动,才能判断任务是否完成。训练时,模型先生成回答或工具调用,环境执行动作并返回结果,奖励函数再为这段交互评分,随后才能更新模型。困难不仅在于计算梯度,还在于把这些不同节奏的步骤连接起来。
AWS以组相对策略优化(GRPO)为例:同一个提示生成多份回答,在开发者环境中分别评分,再利用组内相对表现构造训练信号。训练器完成梯度计算和权重更新后,程序刷新采样器,让下一批生成使用更新后的模型。
这种分工允许奖励函数连接本地验证器、外部工具或测试系统,而不必把整个业务环境都搬进训练服务。但验证器是否可靠、工具调用是否安全、奖励是否会被模型钻空子,仍然是使用者需要处理的问题。
此前本站报道的AWS企业搜索智能体多轮强化学习案例展示的是利用托管训练流程优化完整检索轨迹。本次发布则把训练循环中的更多操作开放给开发者。两者都涉及多轮强化学习,但不是同一次功能发布,也不代表AWS刚刚开始提供这类训练能力。
模型、区域和并发仍有明确限制
官方开发文档当前列出四个基础模型。openai/gpt-oss-20b可在美国东部弗吉尼亚北部、美国西部俄勒冈和亚太孟买区域使用;google/gemma-4-31B-it与Qwen/Qwen3.6-27B支持俄勒冈和孟买;Qwen/Qwen3.8-27B则仅列出俄勒冈。不能把服务覆盖三个区域理解为每个模型在三个区域都可用。
文档列出的默认并发训练会话配额为2,可申请调整。AWS技术说明还提醒,会话在停止或过期前会持续占用并发配额,因此训练完成或发生异常时仍需妥善结束会话。
实际使用也不只是取得一个API地址。前置条件文档要求配置调用者身份、训练会话承担的IAM执行角色,以及保存检查点的模型包组。若采用客户自管VPC或KMS密钥,还需配置相应网络和加密权限。无服务器减少的是基础设施运维,并不取消账户、权限和数据治理工作。
按令牌收费,不等于整个实验没有等待成本
训练会话采用按处理令牌收费的方式,而不是要求用户为整个实验时长预留GPU容量。开发文档将计费维度分为输入预填充(prefill)、生成采样(sample)和训练(train),分别对应输入处理、生成响应和训练更新。
AWS称,当奖励函数在开发者自己的环境中给一批结果评分时,训练会话的GPU计算计费暂停。对于本地评分耗时较长的任务,这种模式可能减少为了等待奖励结果而支付的闲置GPU费用。
但这不是整个项目的免费承诺。本地或外部奖励计算、工具运行、存储以及后续推理部署,仍需分别纳入预算。实际总成本还取决于提示长度、生成数量、训练步数和模型选择。仅凭按令牌计费这一点,无法得出它必然比自管GPU更便宜的结论。
官方示例显示可行性,尚不能替代生产验证
AWS同时公开了训练会话示例仓库,涵盖聊天数据监督微调、数学问题强化学习、编程任务强化学习和基于二元反馈的偏好对齐。仓库展示了如何组织批处理、验证、检查点恢复与指标记录,而不是要求每个团队从零连接全部操作。
配套技术文章报告,在一个GPT-OSS 20B编程训练实验中,团队使用秩为32的LoRA适配器训练50步,每步包含128道题、每题8份响应,并允许模型进行两轮交互。AWS称,该配置在200道留出测试题上的准确率从40%升至50.5%。这些是AWS披露的特定实验结果,并非独立复测,也不能据此保证其他模型或企业任务会获得同样收益。
公告还引用了ImagineSoftware的医疗保险拒赔分流模型实践,以及Karini AI针对Amazon Neptune知识图谱开展多轮工具调用微调的反馈。它们说明厂商正在争取的使用场景,但客户证言不能替代完整的成本、稳定性和业务效果评估。
这项发布更直接的价值,是把“自己设计训练算法”和“自己运营GPU集群”拆成两个可以分别选择的问题。对于预设微调流程已经不够用的团队,它增加了一条工程路径;对于数据质量、奖励定义或评估标准尚未清晰的项目,更多训练控制权并不会自动带来更可靠的模型。