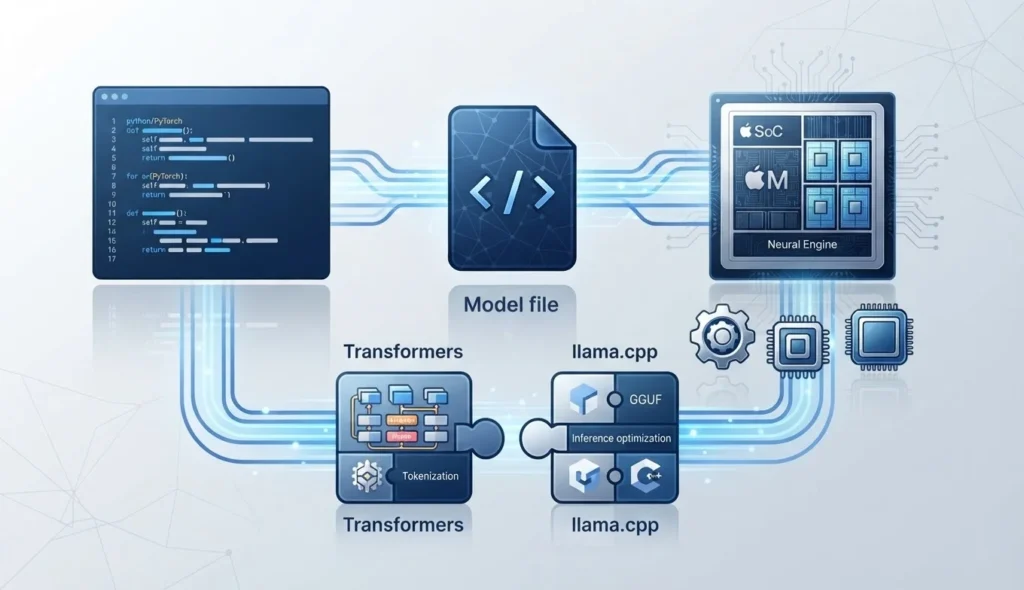
Hugging Face 在 Transformers 中加入对 llama.cpp 的 GGUF 量化模型支持,让开发者可以直接通过 from_pretrained 在 Python/PyTorch 工作流中加载和运行打包量化权重,首批优化面向 Apple Silicon(MPS),重点支持 Qwen3.5 架构。该整合旨在保留 Transformers 的可编程性与评估能力,同时利用 ggml 的 Metal 内核提升本地推理性能,但并未取代针对高效本地推理的 llama.cpp,且当前仍受硬件和架构覆盖的限制。
Hugging Face 正在把 llama.cpp 生态中广泛使用的 GGUF 量化模型,带入 Transformers 熟悉的 Python 与 PyTorch 工作流。用户可以从 Hugging Face Hub 选择一个 GGUF 检查点,通过 from_pretrained 加载并生成文本,而不必为了使用量化权重改换整套开发接口。
Hugging Face 在 2026 年 9 月 22 日发布的技术文章《Transformers now runs llama.cpp quants》称,初始实现重点面向 Apple Silicon,首先支持 Qwen3.5 架构。团队通过 Hugging Face 的 kernels 库复用 ggml 的 Metal 内核,并对 generate 生成流程减少额外开销,目标是在保留 Transformers 可编程性的同时,让本地推理性能接近 llama.cpp。
这并不是要取代 llama.cpp。Hugging Face 明确表示,若用户最关心的是高效的本地推理,llama.cpp 仍是推荐引擎;新的整合主要解决的是另一类问题:让开发者能够在 Python、PyTorch 和 Transformers 的模型定义体系中,直接实验、评估和修改 GGUF 模型。
GGUF把模型压缩和本地硬件连接起来
GGUF 是 llama.cpp 团队开发并广泛使用的单文件模型格式。它可以在一个文件中保存模型权重、元数据、分词器信息以及可选的聊天模板,并支持不同程度的量化。量化通过降低部分权重的精度,换取更小的文件和更低的内存需求,因此较大的模型也有机会在笔记本电脑或其他本地设备上运行。
以 Unsloth 的 Qwen3.5-4B 为例,Hugging Face给出的文件大小对比是:未量化的 BF16 版本为 8.42 GB,Q6_K 为 3.53 GB,Q5_K_M 为 3.14 GB,而 Q4_K_M 为 2.74 GB。Q4_K_M 主要使用 4 位权重,同时为更敏感的张量保留较高精度,是团队建议的本地运行起点;如果设备有更多内存,用户可以尝试 Q5_K_M 或 Q6_K。
不过,文件变小并不意味着模型质量不会变化。Hugging Face提醒,更激进的量化会带来精度取舍,实际影响取决于模型和任务。对于编程、长文本、工具调用等具体工作,用户仍需要用自己的任务进行验证,而不能只根据量化等级判断效果。
在 Transformers 中加载GGUF只需指定文件
目前的使用路径仍处于快速迭代阶段。Hugging Face建议安装 GitHub 上的 Transformers 最新代码以及 kernels:
pip install -U "git+https://github.com/huggingface/transformers.git" kernels
随后,开发者可以在 from_pretrained 中同时传入 Hub 仓库和 GGUF 文件名:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"

tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    gguf_file=filename
)
在兼容的 Apple Silicon 路径上,权重可以保持打包状态,模型直接使用 Metal 上的 ggml 量化内核执行矩阵运算。注意力部分也可以使用 ggml-attn,即 llama.cpp 使用的同类 ggml Metal 注意力实现。若兼容的量化内核无法获取,加载器会回退到反量化路径,模型会占用更多内存;开发者也可以明确要求使用标准的 sdpa 注意力实现。
Hugging Face目前把这种打包推理路径限定在 MPS,也就是 Apple Silicon 的 Metal 后端。其他设备或不支持的量化类型仍可能在加载时反量化。官方文档还指出,当前专门优化的架构主要是 Qwen3.5,兼容的 Qwen3.8 检查点也可以沿用相关路径;其他模型则使用旧的加载机制或等待后续扩展。
同一份GGUF也能通过OpenAI兼容接口提供服务
除了直接在 Python 中调用,开发者还可以使用 transformers serve 启动一个 OpenAI 兼容的接口:
pip install -U "transformers[serving] @ git+https://github.com/huggingface/transformers.git" kernels

transformers serve "unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf"
这里的模型标识由两部分组成:冒号前是 Hub 仓库,冒号后是仓库中的具体 GGUF 文件。这样做是因为一个仓库可能同时包含 Q4、Q5、Q6 等多个量化版本,服务端必须明确选择其中一个。
服务启动后,开发者可以使用支持 OpenAI 兼容接口的客户端连接本地模型。Hugging Face文章举例提到 Jan 或 Pi 等工具:客户端负责对话界面,Transformers则在 Mac 上运行模型。这种分工让本地模型不再只是一个命令行程序,而可以接入编程代理或其他已有的应用工作流。
这类本地工作流正在从“能不能启动模型”转向“模型能否稳定接入应用”。Hugging Face近期为 Apple Silicon 本地推理项目提供更正式维护资源的 oMLX也体现了类似趋势:本地推理的竞争不仅取决于模型权重,还涉及缓存、转换、服务接口和硬件适配。
Hugging Face与llama.cpp的边界仍然清晰
Hugging Face这次整合建立在两套生态的互补关系上。llama.cpp是一套面向本地推理的专用运行时,拥有自己的内存管理、调度逻辑和广泛硬件支持;Transformers则更接近模型定义、训练、评估和研究实验的通用框架。
因此,新的 GGUF 支持为开发者带来的价值,主要包括几方面:
- 在 Python 和 PyTorch 中直接实验量化模型;
- 使用已有的 Transformers 评估流程检查 GGUF 检查点;
- 对比原始模型和 GGUF 转换版本,验证转换是否正确;
- 在
generate中使用自定义 logits 处理器、停止条件或生成循环; - 将 GGUF 权重反量化后,继续进行标准的训练或微调流程。
最后一点需要特别谨慎理解。反量化会把压缩权重重新展开为普通的稠密模型,意味着模型可能重新占用更大的内存,并不等于可以以原有的量化成本进行训练。它的意义在于,开发者可以把本地获得的检查点带回熟悉的研究工作流中,而不必完全依赖专用 C++ 推理运行时。
性能比较接近,但测试条件并不完全相同
Hugging Face以 llama.cpp 作为本地推理性能参照,对三个 GGUF 检查点进行了比较,包括小型稠密模型、大型稠密模型和混合专家模型。测试设备是一台配备 M2 Max 和 32 GB 统一内存的 MacBook Pro,系统为 macOS 26.6,使用 PyTorch 2.12.1 和 kernels 0.17.0。
官方表示,Transformers在三个检查点上的表现都接近 llama.cpp。不过,两边的测试并非完全同条件:llama.cpp一侧使用 llama-bench 报告 128 个解码 token 的生成速度,排除了提示词处理;Transformers一侧则从 12 token 的提示词生成 128 token,并把 prefill 过程包括在内。Hugging Face因此强调,图表不应被理解为严格意义上的同口径基准。
这项限制很重要。专用推理引擎通常会围绕内存管理、批处理和调度进行深度优化,而通用框架的优势则在于可组合性和可调试性。两者的性能差距,最终仍会随模型架构、上下文长度、批处理方式、量化类型以及具体硬件变化。
ggml内核也可能服务于非GGUF模型
Hugging Face认为,更大的机会不只是让 Transformers 读取 GGUF,而是把 ggml 的高效内核带给 llama.cpp 尚未完整支持的模型架构。
目前,Transformers已经包含大量模型的 PyTorch 实现。如果某种架构能够获得适配的量化、归一化或注意力内核,开发者就可能在不等待完整 llama.cpp 实现的情况下获得部分加速。由于内核操作的是张量,而不是必须接收完整的 GGUF 模型,这条路径未来也可能延伸到计算机视觉、音频和多模态模型。
文章列出的首批内核包括:直接读取打包量化权重的 ggml-quantization,融合归一化操作的 ggml-norm,用于提示词处理和 token 解码的 ggml-attn,以及服务于 Qwen3.5 和 Qwen3.8 混合架构的 ggml-gated-delta-net。针对混合专家模型,Hugging Face还实现了用于专家路由的 topk Metal 内核。
这意味着,模型运行时的优化可能不再严格按照“某模型只能绑定某推理引擎”来组织。模型定义、权重格式、底层内核和上层应用接口可以逐步拆分,再通过不同项目组合起来。
Hugging Face最近发布的 Tokenizers v1 候选版也显示,推理体验的瓶颈正逐渐从单个模型层扩展到整个软件栈:分词、内核、生成循环以及 CPU 与 GPU 的协同,都会影响最终的端到端速度。
当前限制决定了它还不是通用本地运行方案
这次发布的目标是 Apple Silicon 上的单次交互式对话,而不是立即覆盖所有硬件和所有模型。当前主要限制包括:
- 高性能的打包推理路径暂时只适用于 MPS;
- 带 padding 的批处理仍需要进一步优化;
generate_batch等批量生成路径还在改进中;- 架构覆盖范围有限,更多模型需要逐步整合和验证;
- 没有兼容量化内核时,模型会回退到反量化,内存开销可能明显增加。
因此,“Transformers支持GGUF”不能简单解读为所有 GGUF 模型都能在所有设备上以 llama.cpp 的速度运行。更准确的说法是:Hugging Face为一部分本地量化模型提供了一个新的、面向 Transformers 用户的加载和运行路径,当前最成熟的场景是 Apple Silicon 上的 Qwen3.5 系列。
未来的关键问题包括更多架构能否获得高效内核支持,批处理性能能否接近单会话性能,以及同一套接口能否覆盖视觉、音频和多模态模型。对于开发者而言,最值得关注的也许不是这次整合能否取代 llama.cpp,而是模型格式、推理内核和研究框架之间的边界是否会因此变得更加灵活。
来源: