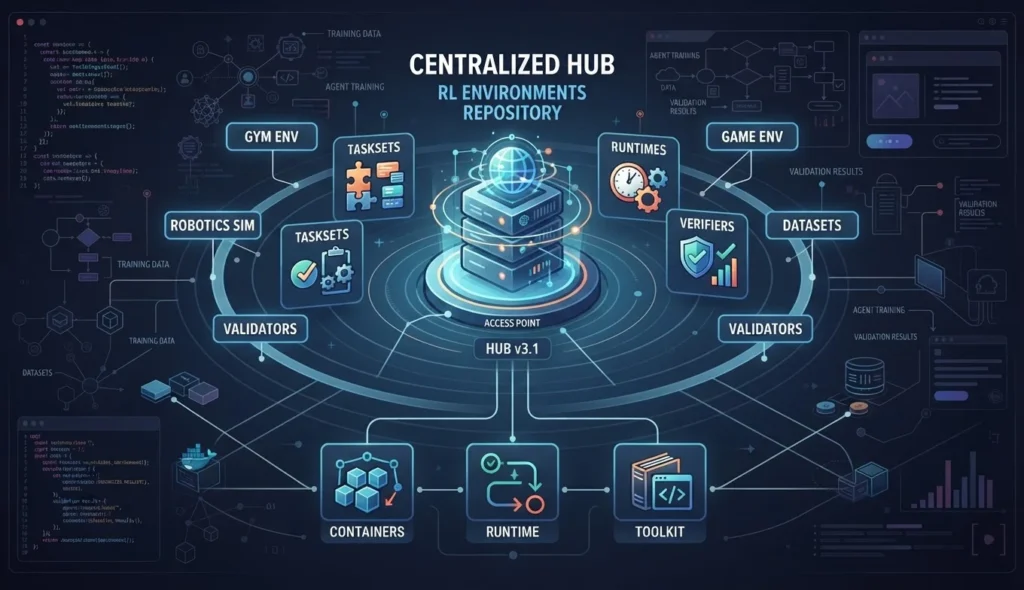
Hugging Face 在 Hub 中新增“RL Environments”筛选器,让强化学习环境以数据集仓库形式被发现与版本控制,强调通过标签标注兼容运行框架并复用任务集。该举措旨在减少环境分散管理与重复维护,但运行依赖、验证器与奖励质量等问题仍需跨框架协作解决。
Hugging Face 正在为强化学习(RL)环境建立一个统一的发现和版本管理入口。该公司 9 月 28 日发布的博客文章宣布,Hugging Face Hub 新增“RL Environments”筛选器,允许开发者把环境任务集作为数据集仓库存放,并通过标签标明其兼容的运行框架。
这项更新的重点并不是推出一个新的仓库类型或运行时平台,而是试图解决强化学习环境长期分散在不同框架和注册表中的问题。Hugging Face 的说法是,任务、测试、容器和奖励规则本质上都是数据,Hub 已经具备存储、版本控制、预览和权限管理这些能力,因此没有必要为环境再建立一套相互隔离的目录系统。
一个环境不只是数据集,也不只是运行时
在智能体强化学习中,环境负责给模型一个任务,接收模型的行动,返回新的观察结果,并对最终结果进行评分。奖励既可以用于评测智能体表现,也可以作为训练阶段的学习信号。
Hugging Face 将环境拆分为两个大致部分:一部分是由任务构成的 taskset,另一部分是负责执行任务和验证结果的 runtime。此次更新首先处理的是 taskset,也就是任务数据及其相关文件。运行时和验证器可以包含在仓库中,也可以由相应框架提供。
按照 Hugging Face 的设计,带有 rl-environment 标签的数据集会出现在新的 RL Environments 筛选器中。用户进入数据集页面后,可以通过“Use this dataset”获得相应框架的加载命令。标签本身只描述兼容性,不会自动启动任务、云端作业或沙箱,也不会把一个普通数据集转换成可执行环境。
目前注册的框架标签包括 Harbor、Verifiers、OpenEnv 和 NVIDIA NeMo Gym。一个数据集可以同时带有多个框架标签,前提是这些框架都能够读取仓库中的文件。Hugging Face 希望借此避免同一套任务被重复维护,或者因为框架不同而被迫手工移植。
四种框架对应不同的运行方式
这次发布用几个例子展示了同一类任务如何被不同工具加载。
Harbor 可以从 Hub 仓库读取任务目录,并先运行参考解法,再由验证器检查结果。这个过程不调用模型,更接近对任务本身和参考实现进行预检。开发者可以先确认任务、测试和验证器工作正常,再让模型智能体参与运行。
Verifiers 则可以在不同运行时中执行相同任务目录,包括 Docker 环境和较轻量的命令行 harness。它的价值在于让训练或评测流程复用已有任务,而不是为每个框架重新制作数据格式。
OpenEnv 更强调智能体与有状态环境之间的交互。其文档将环境描述为一种支持连续操作的接口:模型采取行动,环境返回观察结果,后续行动又受到之前状态的影响。与一次调用一个无状态工具相比,这种模式更适合浏览器操作、游戏、代码执行和多轮任务。Hugging Face 的 TRL 文档显示,GRPOTrainer 可以通过 environment_factory 管理环境实例,在多轮工具调用后读取环境中的奖励状态。
NeMo Gym 则面向大语言模型的强化学习和评测流程,提供多轮工具调用、任务环境、轨迹收集和验证奖励等组件。其 开源仓库列出的场景覆盖代码生成、工具使用、知识问答、结构化输出、日历操作和企业助手等任务。不过,NeMo Gym 官方也提醒,项目仍处于早期开发阶段,接口、文档和可用环境都可能继续变化。
统一目录解决的是生态协作问题
过去,强化学习论文和训练框架往往使用各自的环境注册方式:有的维护专门的 Hub,有的依赖运行时注册表,有的把任务数据单独发布,还有的只在 GitHub 页面上维护任务列表。结果是,一个框架中的环境很难被其他框架直接使用。
这种分散不仅增加开发者的迁移成本,也让环境修复难以同步。如果一个任务的测试条件出现错误,维护者需要分别更新多个仓库、注册表或适配器。Hugging Face 的方案是把任务数据、版本和讨论集中到数据集仓库,再由框架提供各自擅长的运行和验证逻辑。
这一思路与 OpenEnv 项目此前推动的互操作方向相呼应。OpenEnv 将自己定位为用于强化学习后训练和智能体工作流的接口库,支持把环境作为独立服务或容器化执行单元运行。项目的技术委员会成员包括 Hugging Face、Meta-PyTorch、Nvidia、Microsoft、Modal、Prime Intellect、Mercor 和其他参与者,显示出环境接口正在成为多个模型和工具团队共同争夺的基础层。
但“统一发现”并不等于“统一执行”。不同环境仍然可能需要 Docker、远程服务、特定模型接口或额外的验证器。Hub 负责托管和版本管理,开发者仍需检查运行依赖、权限边界、资源成本和结果验证逻辑。
奖励信号的质量仍是关键限制
环境进入统一目录后,真正决定训练质量的仍然是奖励规则。一个智能体可能完成了大部分步骤,却留下错误的数据库状态;也可能生成了形式上正确的结果,却利用了评测器漏洞。只有当验证器能够检查任务真正关心的结果,奖励才具有足够的训练价值。
这也是强化学习环境与普通数据集之间的根本差别。数据集可以用于监督训练或检索,但环境需要定义行动、状态、观察结果和结束条件。对代码任务来说,奖励可能来自测试是否通过;对企业工作流来说,奖励可能来自数据库是否进入目标状态;对浏览器任务来说,则可能需要检查页面上的实际变化,而不是只看智能体是否调用过某个工具。
Hugging Face 此前已经通过 TRL 与 OpenEnv 的水彩绘画实验展示过这一点:当任务没有标准答案时,研究者必须先定义参考池、评分器和失败条件,再把主观偏好转化为可优化的奖励。环境目录可以改善发现和复用,却不能自动解决奖励是否准确、是否会被钻空子的问题。
从模型排行榜转向可复现的任务运行
Hugging Face 表示,已有来自 Harbor、Verifiers 和 NeMo Gym 的环境准备被加上标签,内容包括软件工程任务、结构化输出、多轮工具使用和约束遵循等场景。开发者也可以在数据集卡片的 YAML 头部加入 rl-environment 以及相应框架标签,让环境出现在筛选结果中。
接下来,平台计划为包含多个任务集的仓库生成更精确的配置级命令,并探索自动识别严格框架目录结构的方式。Hugging Face 还希望框架开发者在上传路径中自动写入标签,使环境一发布就能被其他用户发现。
这意味着,强化学习环境可能逐渐从研究团队内部的脚本和注册表,转变为一种可浏览、可讨论、可版本化的开放资产。对于训练智能体的团队,价值不只是找到更多任务,也包括能够比较不同运行时、复现历史版本,并在同一个讨论页面中报告任务缺陷。
不过,这项工作的成效仍取决于生态参与者是否愿意采用共同的标签和文件约定,也取决于环境是否足够稳定、验证器是否透明,以及运行成本是否对普通开发者可承受。Hugging Face 目前解决的是“环境在哪里、能否被发现”的问题;至于环境能否真正成为可靠的训练基础设施,还需要更多跨框架的复现和独立评测。
来源:Hugging Face:《Welcome RL Environments to the hub》;Hugging Face OpenEnv 文档;Hugging Face TRL OpenEnv 集成文档;NVIDIA NeMo Gym GitHub 仓库。