Mistral 发布 Voxtral 3,将实时语音转写、文本转语音与 Voice Agent SDK 组合为面向多语种实时交互的完整技术栈,支持电话、WebRTC、SIP 接入并能在对话中持续完成多步骤任务。该套件包括多版本转写模型、可上下文适配的语音生成与可替换模块的实时代理 SDK,强调私有化部署与企业级接入,但真实生产效果仍需企业在权限、审计与容错上自行验证。
法国人工智能公司 Mistral AI 于2026年10月20日发布 Voxtral 3,将语音转写、文本转语音和语音智能体开发工具组合成一套面向实时交互的技术栈。公司称,新系统能够在多语言对话中完成听取、推理、工具调用和语音回应,并可连接电话、浏览器、WebRTC、SIP以及企业内部系统。
这次发布的重点,不只是推出一个识别语音的模型,而是试图把语音代理从“能听见、能回答”推进到“能在通话中持续完成任务”。Mistral给出的示例包括核验身份、查询账单、搜索信息以及预约服务等多步骤操作。
Voxtral 3包含哪些模型
Voxtral 3的语音转写部分包括面向录音文件的 Voxtral Small Transcribe 3、Voxtral Mini Transcribe 3,以及面向实时流式场景的 Voxtral Mini Transcribe Realtime 3。
其中,Small版本面向较高质量的多语种转写和说话人识别。Mistral称,该模型支持50多种语言,并加入说话人分离、上下文偏置和结束语检测等能力。上下文偏置允许开发者提供专业术语、产品名称或其他关键词,以改善特定领域的识别结果,而不必先进行微调。
Mistral官方文档将 Small Transcribe 3列为公开预览版本,定价为每分钟0.004美元。官方页面还列出了该模型在转写、说话人分离和多语言评测中的比较结果,但这些结果属于Mistral自有评测或厂商披露,不能直接视为独立第三方基准。
Realtime版本则面向语音智能体和实时字幕。Mistral在发布公告中称,它在超过35种语言上可实现低于500毫秒的实时转写延迟;文档显示,开发者还可以根据会话需求配置流式延迟,并使用内置的结束语检测、上下文偏置和说话人分离功能。官方文档列出的 Realtime Transcribe 3价格为每分钟0.008美元。
这类设计解决的是实时语音系统中的一个实际问题:代理不仅要知道用户说了什么,还要判断用户是否已经说完。如果系统过早打断,交流会显得生硬;如果等待过久,用户则会感到系统没有反应。Mistral称,Voxtral的结束语预测同时参考声学和语义信息,试图在两者之间取得平衡。
Voice Agent SDK把语音、推理和工具调用串在一起
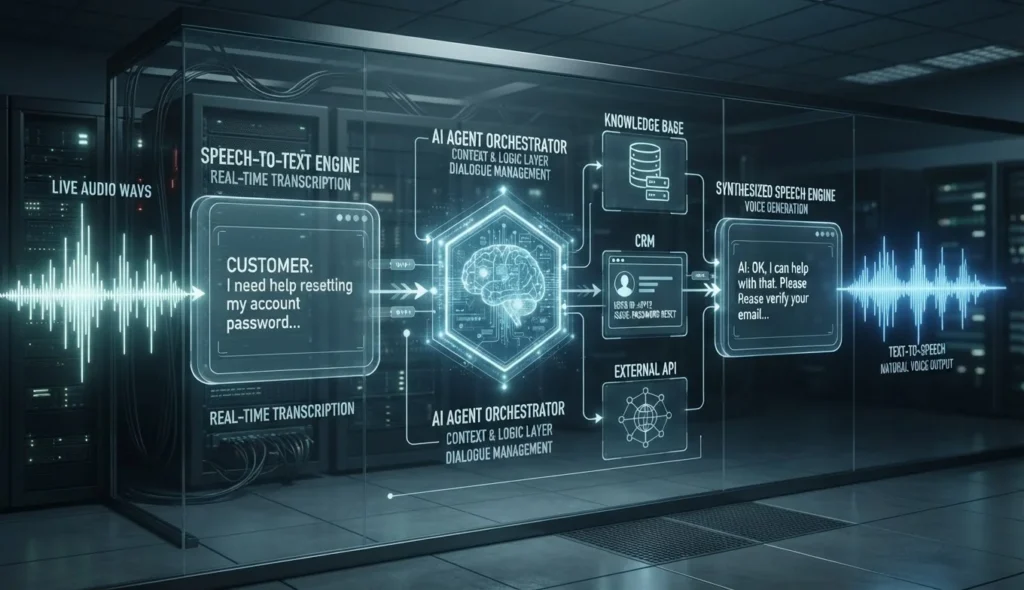
Voxtral 3的另一项核心发布是 Voice Agent SDK。Mistral称,这套SDK基于 LiveKit,将实时语音输入、语言模型推理、工具调用和语音输出放入同一个流式流程。
在其描述的典型架构中,Voxtral Mini Transcribe Realtime 3负责听取用户发言,通用语言模型负责理解意图、推理和调用工具,Voxtral Speech 3则根据上下文生成语音回复。各阶段以流式方式并行推进,而不是等一个阶段完全结束后再启动下一个阶段。Mistral称,完整对话轮次可以在一秒以内完成,并能够在用户插话时停止继续说话。
SDK支持通过函数调用、网页搜索和企业内部检索系统获取信息。它可以通过 SIP接听或拨打电话,也可以运行在浏览器和应用中的 WebRTC连接上,并与现有的电话、交互式语音应答系统和联络中心软件对接。
Mistral还强调,SDK中的不同阶段可以替换:开发者可以更换负责推理的语言模型、语音模型或语言,而不必重写整个智能体。这种模块化设计对企业部署尤其重要,因为企业通常需要在模型能力、数据驻留、延迟、成本和合规要求之间做出取舍。
官方公布的 Voice Agent API价格为:使用 Mistral Small 4作为推理模型时,每分钟0.04美元;使用其他推理模型时,每分钟0.08美元。若希望在本地或私有云中运行完整技术栈,则需要与Mistral另行洽谈。
语音生成从“读出来”转向适应语境
Voxtral 3还包括文本转语音模型 Voxtral Speech 3。Mistral称,该模型支持35种以上语言和50多种方言,并可以根据上下文调整语气、语速、重音和情绪。官方产品页列出的语音生成价格为每100万个字符13美元。
与简单地把文字转换成声音相比,Mistral希望语音模型能够理解一句话在对话中的作用。例如,同一句内容在客服解释、紧急提醒或轻松闲聊中,需要使用不同的节奏和强调方式。公司提供的示例包括日期、货币、专有名词和非标准发音的处理,以说明语音生成模型在真实对话中的细节问题。
Mistral同时介绍了 Pro Voice语音适配能力。公司称,使用约30分钟的音频样本,系统可以复现说话者的音色特征、情感范围和说话风格,并支持跨语言语音适配。这个能力可能适用于品牌客服、培训和内容制作,但也会带来身份冒用、授权范围和音频数据保存等问题。官方发布页强调,企业可以选择在Mistral的欧洲托管API上运行,或在自有基础设施中部署,以控制音频处理位置和是否保留对话。
这类语音能力的评估不能只看“像不像真人”。Hugging Face推出开放TTS排行榜的经验显示,可懂度、声音相似度、首段音频到达时间和人工听感分别反映不同问题。单一分数很难代表语音在所有语言、硬件和互动环境中的表现。
从语音识别到语音代理,工程难点正在转移
Mistral此次发布的意义,在于它把语音代理的竞争从单一模型指标扩展到了完整运行链路。一个可用的语音代理需要同时处理识别错误、打断、工具调用延迟、语音生成、权限控制和失败恢复。任何一环出现问题,都可能破坏用户对整段对话的信任。
说话人分离就是其中一个容易被低估的环节。NVIDIA推出Nemotron 3 Diarization,就把重点放在实时判断“谁在什么时候说话”。对于电话客服、多人会议和语音代理而言,如果系统无法可靠区分客户、客服和旁听者,后续的摘要、行动项和工具指令都可能被错误归属。
同样,低延迟也不等于高可靠性。实时转写系统需要在背景噪声、口音、专业词汇、多人同时说话和网络波动下保持稳定;工具调用则需要面对权限不足、接口超时和任务执行失败。Mistral的产品页主要展示能力和内部比较,尚不能替代企业在自己的电话录音、业务术语和工作流中的独立测试。
这一点也可以从实时语音产品的发展中看到。此前,Google对实时语音模型的报道已经从“能否自然对话”扩展到后台工具调用、可视化形象和任务执行。Gemini 3.8 Live with Live Avatar的企业化尝试显示,竞争已经不再局限于语音合成质量,而是延伸到代理如何在交流过程中持续执行工作。
私有化部署是Mistral的差异化路径
Mistral将可控部署作为Voxtral 3的重要卖点。公司称,企业可以使用欧洲、美国或全球API端点,也可以在自己的基础设施上部署相关模型。对于医疗、金融、客服和政府等涉及敏感语音的场景,这意味着企业可以对音频处理地点、访问权限和保存期限拥有更大的控制权。
但“可以私有化部署”并不自动等于“风险已经解决”。企业仍需要明确哪些音频会被发送到外部服务、哪些工具可以被代理调用、语音克隆样本保存多久,以及用户能否在关键操作前进行确认。尤其是接入电话、浏览器和企业系统后,语音代理拥有的权限可能比普通聊天机器人更接近一个能直接执行动作的业务接口。
从这个角度看,Voxtral 3更像是Mistral对企业语音代理市场的一次完整押注:模型本身负责听和说,语言模型负责推理,SDK负责把工具和业务系统接入实时流程,部署方式则试图回应企业对数据主权的关注。它能否成为稳定的生产系统,最终仍取决于模型之外的授权、审计、人工接管和错误恢复设计。