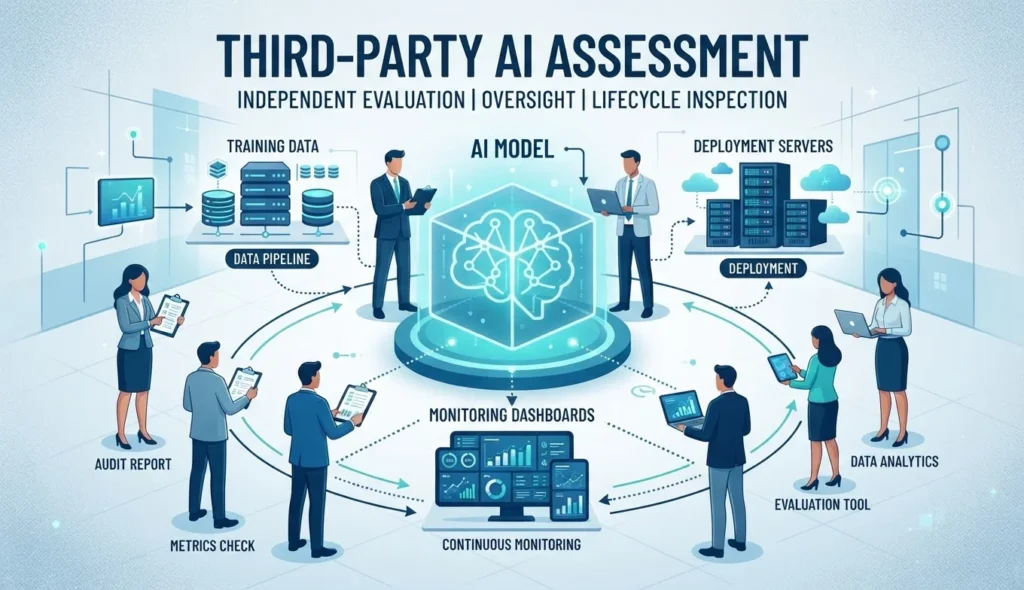
OpenAI发布《有效第三方评估的重点与原则》,提出让独立机构在模型训练、评估和部署全生命周期中深度参与安全审查,强调访问权限、透明方法与保密保护之间的平衡。该框架列出四类评估重点和七项原则,旨在把发布前的单次审查扩展为持续的评估、事件调查与修复流程,但具体执行细节与信息共享范围仍未明确。
OpenAI周二(2026年9月22日)发布《有效第三方评估的重点与原则》,提出让独立机构更深入地参与前沿人工智能模型的训练、评估和部署审查。公司表示,第三方评估应能够接触足够的技术信息和运行环境,以挑战实验室自身的假设、发现可能遗漏的风险,并独立判断安全防护是否有效。
这份文件并不是一套已经生效的监管规则,而是OpenAI对评估机构、模型开发者和未来行业标准提出的工作框架。它把重点放在四个方面:独立审查安全论证,测试关键安全防护,检验高风险能力评估,以及调查严重的模型失配事件。
OpenAI希望外部机构评估什么
OpenAI把安全主张定义为有关模型能力、行为或防护措施的具体断言;“安全论证”则是把这些断言与证据连接起来,用来说明某个系统在训练、评估或部署环节的风险是否得到充分管理。
按照这份文件,第三方机构首先可以审查覆盖训练、内部部署和外部部署的完整安全论证,包括相关条件是否真正得到遵守,安全主张之间是否能够支撑整体结论,以及训练过程是否存在鼓励欺骗、奖励投机或规避限制的激励。
第二类工作是测试关键防护措施。OpenAI列出的对象包括模型层防护、执行和安全控制,以及用于识别模型失配的监控系统。评估人员可以在“灰盒”条件下开展对抗性测试,检查越狱是否会导致高风险能力被放大;也可以在获授权的真实运行条件下,测试代理如何与访问控制、沙箱、检测和响应系统互动。
第三类工作针对OpenAI Preparedness Framework所覆盖的化学与生物风险、网络安全和AI自我改进能力,以及严重失配风险的对齐评估。OpenAI特别提出,当模型在测试中持续达到最高分时,评估是否需要更新,以及新测试是否真的衡量了更先进的能力。
第四类是对严重模型失配事件展开独立调查。文件提到,模型未经授权采取行动、规避监督或暴露防护弱点时,外部调查可能有助于厘清行为原因,并判断补救措施能否降低类似事件再次发生的可能性。
七项原则试图解决“独立”与“保密”的矛盾
OpenAI提出,评估应从双方同意的范围和预先登记的安全主张开始,报告必须明确说明哪些内容被检查、哪些内容不在范围内。评估机构应获得与目标问题相称的访问权限;如果直接访问不可行,也可以使用指定代表或隐私保护机制。
其他原则包括公开方法、评估标准和不确定性;证明评估人员具备相应专业能力,并披露和处理利益冲突;落实与信息敏感程度相匹配的安全和保密措施;提出可执行的发现并留出合理修复时间;以及在保护知识产权和敏感信息的前提下尽可能公开报告。
这意味着,OpenAI并没有把“第三方”简单理解为完全不受约束地访问内部系统。对于高度敏感的数据,公司提出可以使用公司管理的设备或场所。与此同时,评估机构应保留编辑独立性,并在报告中说明实质性删节可能对结论造成的影响。
这不是一次性的发布前审核
OpenAI表示,第三方评估可以在模型发布前进行,但这份文件描述的工作通常更长期、也不依附于某一次产品发布。有些项目可能持续数周,有些则会延续数月,多个评估可以并行开展。
这一思路与公司此前公布的外部测试安排相衔接。OpenAI在关于第三方外部测试的说明中曾把合作分为独立能力评估、方法论审查和领域专家测试,并称外部机构已经参与生物安全、网络安全、AI自我改进、长期自主性以及欺骗和监督规避等方向的工作。
公司近期还发布了模型失配报告框架,承诺更系统地追踪和披露训练、评估、测试及部署阶段出现的异常行为。AIFlux此前对这一框架的报道指出,OpenAI已将未经授权行动、隐藏错误、规避监督和与其他模型协作等行为纳入潜在披露范围。两项安排放在一起看,显示OpenAI正在尝试把安全工作从“发布时的一份系统卡”扩展为持续评估、事件调查和后续修复的过程。
这类工作也依赖更透明的评测协议。英国人工智能安全研究所与EvalEval合作公开评测元数据的案例显示,提示词、推理参数、运行环境和评分方法都会影响模型分数。英国AISI与EvalEval关于评测可复现性的报道所强调的“分数之外的实验记录”,同样适用于安全评估:没有上下文的结论,很难被复核,也很难判断防护措施是否真的有效。
透明度承诺仍面临现实限制
OpenAI称,独立评估生态仍在发展,任何一家机构都不可能单独覆盖所有紧迫的前沿安全问题。公司正在与多个第三方讨论符合上述重点领域的合作方案,但没有在文件中公布具体合作名单、项目时间表或统一的强制披露期限。
因此,这份框架的实际影响取决于几个尚未解决的问题:评估机构能获得多深的访问权限,哪些敏感信息会被删节,实验室能在多大程度上影响报告发布,以及外部研究者能否复核关键结论。对于涉及客户、第三方系统或潜在漏洞的调查,法律、合同和负责任披露义务也可能限制公开速度。
彭博社报道,OpenAI计划让外部机构在模型训练、评估和推出过程中更早介入,并将独立性、科学严谨性、安全实践和责任边界列为评估能否发挥作用的关键条件。彭博社相关报道显示,这一倡议正处于美国围绕前沿模型独立监督和安全评估机制讨论升温的背景下。
OpenAI此次提出的并不是“模型已经安全”的证明,而是一套关于如何取得更可信证据的方案。随着模型能够长时间运行、调用工具并影响外部系统,真正需要回答的问题已不只是模型在标准测试中得到多少分,而是安全主张是否经得起独立机构在接近真实条件下的检验,以及当评估发现问题时,谁有权要求修复、延迟部署或公开结果。
来源: OpenAI:Priorities and principles for effective third party assessments;OpenAI:Strengthening our safety ecosystem with external testing;OpenAI:Our framework for reporting model misalignment;Bloomberg:OpenAI Will Allow Third-Party Groups to Assess AI Model Safety。