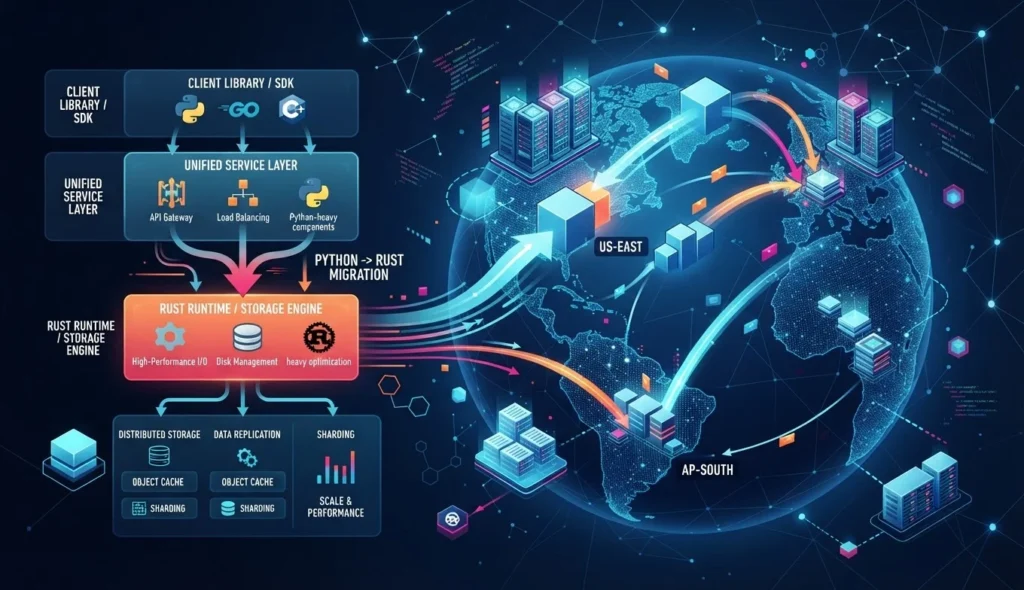
OpenAI披露了其在线存储平台Habitat的设计与演进,称平台每秒处理超过7000万次请求、承载超过500 PB数据并每周服务超过10亿人。文章介绍了Habitat从Python客户端库到独立服务再到Rust重写的路径,以及集中化存储逻辑带来的部署、可观测性和安全性改进,同时指出仍有多项细节待后续披露和验证。
OpenAI在9月11日发布的一篇工程文章中,披露了在线存储平台Habitat如何伴随ChatGPT、API、Codex及内部服务扩展。公司称,Habitat目前每秒处理超过7000万次请求,服务覆盖近40个地理区域,承载的数据规模超过500 PB,相关产品和内部系统每周服务超过10亿人。
这些数字均来自OpenAI的工程披露,尚未有独立机构对其规模、效率或用户覆盖进行复测。OpenAI所说的“每周超过10亿人”是产品服务覆盖范围的表述,并不等同于10亿名付费用户。
从一个Python客户端库开始
Habitat最初并不是一个独立的平台,而是一个连接Azure Cosmos DB的Python客户端库。它于2024年年中开始服务于ChatGPT主服务器,最初只支持一小组数据存取操作,目标是让产品工程师无需直接处理数据库管理工作。
随着使用范围扩大,Habitat逐渐集中承担了数据存储背后的多项复杂任务,包括模式查询、请求路由、访问控制、加密、序列化、连接池管理、缓存和数据驻留等。OpenAI的产品团队可以通过统一接口访问不同的存储资源,而不必分别处理Azure Cosmos DB、缓存或其他底层系统的差异。
OpenAI表示,Habitat如今服务于ChatGPT、API、Codex和内部服务。按照文章给出的架构,平台还与Azure Cosmos DB、Nanobase、Valkey、Blob存储以及变更数据捕获服务等组件协同工作。
这类抽象层的价值不只是减少重复开发。当每个产品团队分别维护一套数据库客户端时,底层协议、路由和权限的变化往往需要分散部署。OpenAI的工程师发现,随着服务数量增加,客户端库的升级变得越来越难以协调。
统一服务减少部署和故障扩散
OpenAI举例说,公司曾希望把关键数据迁移到多个区域分布的Azure Cosmos DB账户,以降低单一区域故障的影响。若这项逻辑仍然放在客户端库中,就需要向数十个服务逐一发布更新、启用功能开关,并进行影子流量测试。
这种方式不仅耗时,也增加了服务之间版本不一致的风险。一个团队因其他原因回滚服务,可能重新带回已经修复的客户端问题,从而触发原本试图避免的故障。
因此,OpenAI后来把Habitat从客户端库改造成独立服务。存储逻辑被集中到服务端后,部署、可观测性和平台能力可以由一个控制点统一管理。改进不再需要等待每个产品团队分别接入,也能让访问控制、审计日志和底层存储资源的限制更加集中。
这一变化也使Habitat成为OpenAI数据安全架构的一部分。公司称,平台可以在统一位置执行访问控制策略、记录审计信息,并限制外部、内部及智能体访问底层数据资源的方式。不过,文章没有披露完整的权限模型、审计范围或不同产品之间的具体隔离规则。
Python先承担增长,Rust再解决效率问题
将客户端库改造成高吞吐服务后,OpenAI仍选择暂时使用Python。公司承认,Python服务会带来更高的网络延迟,以及更多CPU和内存开销,但当时的首要目标是尽快建立核心API、稳定平台,并解除产品团队的开发瓶颈。
Habitat处理的并不只是数据库请求转发。它还承担路由、压缩、加密、校验和、下游健康检查、请求影子测试以及请求对冲等CPU密集型任务。OpenAI称,在异步Python服务中,调度延迟可能成为尾部延迟的重要来源;由于单个用户请求可能触发数百次数据库调用,最慢的一次调用也可能直接影响用户感知。
随着平台继续扩大,Python版本一度达到每秒处理超过2000万次请求,并成为OpenAI内部按核心数计算规模最大的服务之一。到了2026年第二季度,OpenAI决定完成从Python到Rust的迁移。
公司称,团队只使用了两名工程师、Codex和GPT-5.5,就完成了整个服务的Rust重写。目前,Rust版本已经承载95%的生产请求,Python版本计划在未来几周内完全退出。按照OpenAI披露的数据,Rust服务的CPU效率约为Python版本的6倍,内存效率约为15倍,同时平均延迟和尾部延迟也有所下降。
不过,这些效率比较的测试条件、工作负载构成和成本口径,文章并未完整说明。因此,6倍CPU效率和15倍内存效率应被视为OpenAI在自身生产环境中的测量结果,而不是可直接推广到所有Python与Rust服务的通用结论。
OpenAI此前把Codex用于更大范围的软件交付流程,包括需求拆分、实现、测试和生产问题排查;这次Habitat迁移则提供了一个更具体的基础设施案例。AIFlux此前报道的OpenAI发布Agents API,将Codex背后的智能体运行环境开放给开发者也显示,OpenAI正在尝试把模型能力、执行环境和长期任务管理结合成平台层能力。
规模扩大后,存储本身成为下一道瓶颈
OpenAI在文章中把Habitat描述为两部分系列的第一篇。下一篇将进一步讨论存储层、多租户可靠性、读性能优化,以及Habitat如何扩大与Azure Cosmos DB的合作。
这意味着,当前披露的Rust迁移只是平台演进的一部分。服务层的CPU和内存效率提升,可以缓解计算资源压力,但无法单独解决数据分布、跨区域复制、容量管理、缓存一致性或底层数据库吞吐等问题。当平台承载超过500 PB数据、每秒处理超过7000万次请求时,任何一层出现瓶颈,都可能影响ChatGPT、API和Codex等多个产品。
从Habitat的演进路径来看,OpenAI采取的是分阶段建设方式:先用客户端库降低产品团队接入数据库的门槛,再把逻辑集中到独立服务中,最后通过Rust重写解决服务规模扩大后的资源效率问题。这种做法并不是一次性追求完美架构,而是在快速增长过程中,把最紧迫的运营问题逐步转化为平台能力。
但公司的披露也留下了一些待回答的问题,包括“每周超过10亿人”的统计口径、不同产品和地区之间的流量构成、500 PB数据的具体分类、Rust迁移带来的实际成本变化,以及Habitat在数据驻留和多租户隔离方面的可验证指标。这些内容可能要等到系列第二篇或后续技术文章公布后,才能得到更完整的解释。
来源: