OpenAI发布测试显示其最新模型在COBOL、Fortran、Visual Basic、OCaml等低资源编程语言上的能力显著提升,能够在构建新软件与迁移旧系统两类任务中保持或还原原有行为。公司公布了MultiLangBench评测与COBOL迁移测试结果,并计划开源评测与测试套件,同时提醒生产环境迁移仍需专家审核与全面验证。
OpenAI表示,其最新模型在COBOL、Fortran、Visual Basic和OCaml等低资源编程语言上的表现明显改善,目标是帮助企业维护、调试和迁移那些仍支撑金融、气象和关键公共服务的软件系统。
这家公司在10月19日发布的《Advancing Coding in Low-Resource Programming Languages》中说,低资源编程语言的代码和技术文档通常少于Python、JavaScript等主流语言,但它们并不意味着已经退出生产环境。OpenAI引用IBM资料称,COBOL支撑超过40%的网上银行系统、80%的线下信用卡交易和95%的ATM交易;Fortran则被用于天气预报和核反应堆安全分析。
OpenAI此次的重点不是宣布一门新语言或一个独立的编译器,而是通过两项评测,展示模型在“构建新软件”和“保留旧软件行为”这两类任务上的进步。
两项评测分别考察构建与迁移
第一项评测名为MultiLangBench,要求模型从零开始,用20种编程语言构建一个兼容SQLite的数据库引擎。模型需要组织代码库、管理状态、处理错误并逐步添加功能。评测以数据库文件作为统一接口,再使用参考SQLite实现检查结果是否正确,从而让不同语言的实现可以在相同测试下比较。
OpenAI称,在最高推理强度下,GPT-6 Astra在20种语言上的平均测试通过率为87.4%,高于GPT-5.6 Sol的26.8%,而且每一种受测语言都有提升。其中,Astra在COBOL上的通过率从10.9%升至72.1%,OCaml从25.6%升至85.8%,Fortran从21.4%升至83.5%,Visual Basic从27.5%升至89.4%。公司说,Astra在20种语言中的19种得分超过83%,但COBOL仍是最难处理的语言,得分为72%。
GPT-6 Luna则被定位为成本更低的选择。OpenAI称,Luna在同一评测中的平均通过率为40.3%,平均每个样本的估算API成本为0.77美元;GPT-5.6 Sol的对应成本为3.48美元,前者约低78%。这些成本和性能数字来自OpenAI自己的评测与估算,实际结果仍会受到任务、推理强度和调用方式影响。
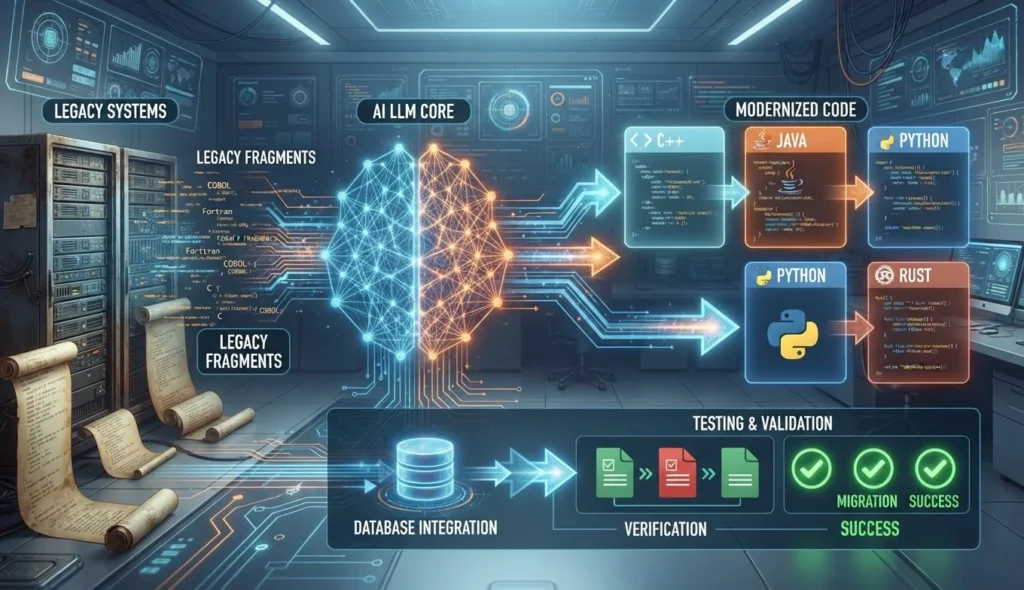
第二项评测聚焦COBOL迁移。模型需要把COBOL程序迁移到C++、Java、Kotlin、Python或Rust,同时保留原程序的行为。OpenAI特别强调,迁移并不只是把语法换成另一种语言:金融程序中的舍入规则、缺失记录的处理方式和业务定义,都可能隐藏在旧代码里。
在一个例子中,COBOL的定点算术会在没有明确要求舍入时直接丢弃多余小数位。如果改写后的程序自动进行舍入,即使程序能够正常运行,也可能产生不同的财务结果。为检验这类问题,OpenAI使用隐藏测试,并要求迁移后的程序在可观察输出上实现逐字节一致;只有通过全部测试,迁移才算成功。
OpenAI称,GPT-6.1 Sol在低推理强度下的准确率为86.6%,而GPT-5.6 Sol为5.4%,前者API成本约为后者的61%。在更高推理强度下,GPT-6.1 Sol的准确率达到97.9%,接近该评测的上限。
旧系统的难题不只在语言本身
OpenAI说,这项工作受到开发者和企业客户反馈的推动。许多旧系统面临的困难并非单纯的语法问题:文档可能不完整,最初编写代码的工程师可能已经离职,关键业务规则也可能只存在于代码之中。
这使“让模型会写COBOL”与“让模型能够安全地修改一个真实的COBOL系统”成为两件不同的事。前者可以通过代码生成测试观察,后者则需要理解依赖关系、数据格式、运行环境和业务责任。即使迁移评测结果很高,OpenAI也承认,生产系统仍需要专家审核,并要根据实际业务规则和系统依赖进行测试。
这一点也解释了为什么OpenAI把评测设计成较长的软件工程任务,而不只是若干代码片段。模型需要在一个代码库中持续工作、运行测试并处理错误。对于企业来说,真正有价值的指标可能不是模型一次生成了多少行代码,而是它能否减少返工,同时保持原有系统的可验证行为。
OpenAI此前发布的GPT-6开发指南也强调,开发者应以完整任务的成功率、返工和审核成本衡量模型,而不是只看单轮回答或每百万个token的价格。对于旧系统迁移,这种工作流视角尤其重要:编译通过不等于业务行为没有改变。
MultiLangBench将向开发者开放
OpenAI表示,将在GitHub发布MultiLangBench的评测设置、测试套件以及各语言的结果,开发者可以检查评测具体测试什么,并观察模型在自身使用的语言上存在哪些缺口。
这类公开评测有助于把“模型支持多少种语言”从营销表述转化为更具体的工程问题。不同语言的标准库、编译器、方言和企业代码风格可能差异很大;一个模型在合成测试中通过率较高,并不自动意味着它能够处理某一家银行或制造企业的全部遗留系统。
OpenAI的结果也显示,低资源语言的改进并不均衡。GPT-6 Astra在多数语言上取得较高通过率,但COBOL仍明显落后于OCaml、Fortran和Visual Basic。对于模型开发者而言,下一步不仅是扩大语言覆盖面,也包括建立更接近真实企业代码的评测,并明确哪些结果来自公司自测、哪些结果经过独立验证。
对使用这些语言的企业来说,人工智能可能首先成为一种辅助工具:帮助工程师理解旧代码、定位缺陷、生成迁移草案和补充测试,而不是直接替代专家完成系统重写。只要旧程序仍在处理支付、气象预测或安全分析,保留原有行为和建立可追溯的审核流程,就仍然比生成一份看似现代的新代码更重要。