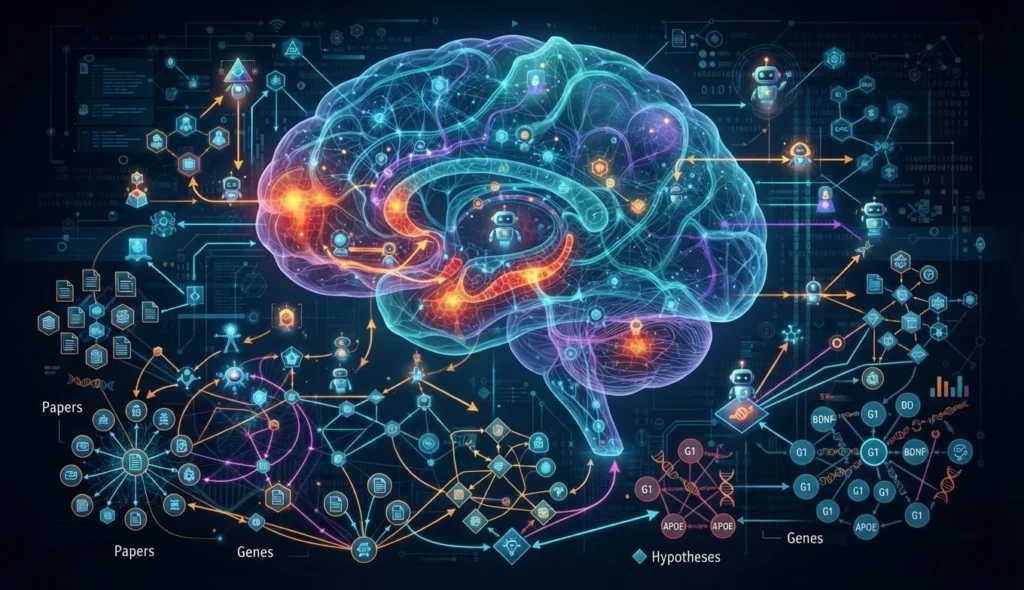
OpenAI、PerturbAI与Scripps Research 使用近2000个由 GPT-Rosalind 驱动的 AI 代理并行分析全脑基因扰动数据,在约32分钟内重建大部分已有发现并提出新的可验证生物学假设,但所有结论仍需实验验证与同行评审。
OpenAI、PerturbAI与Scripps Research表示,他们让近2000个由GPT-Rosalind驱动的AI代理并行分析全脑基因扰动数据,在约32分钟内完成一项研究团队估计需要数月、甚至一年才能完成的解读工作。研究结果提出了与神经退行性疾病相关的潜在线索,包括基因扰动与胆固醇代谢之间可能存在的联系。
但这项工作的意义并不在于AI已经发现了新药。更准确地说,它展示了一种把大规模生物实验转化为可检索证据、研究假设和后续实验优先级的方法。相关论文目前仍是未经同行评审的预印本,所有生物学发现都需要进一步实验验证。
从一项实验分配到近2000个代理
OpenAI在10月21日发布的官方介绍称,团队把分析任务拆分给大量AI代理。每个代理负责研究一种基因扰动,读取不同细胞类型中的基因表达变化,检索科学文献,并尝试解释这些变化可能对应的生物学机制。
随后,系统把各个代理的报告组合成一个“推理图谱”,将基因、细胞反应、相关论文和潜在机制连接起来。研究人员可以在图谱中搜索某一项扰动,查看它影响了哪些细胞类型、对应哪些文献,以及哪些假设值得进入实验阶段。
论文发表于bioRxiv预印本平台,题为《Distributed AI agents enable comprehensive discovery of biological insights at scale》。论文作者来自Scripps Research、OpenAI、PerturbAI和加州大学圣迭戈分校等机构。论文明确说明,该版本尚未通过同行评审。
研究团队运行了1,946个AI代理,每个代理对应一个扰动分析任务。它们使用细胞类型分辨的差异表达基因数据、实验背景、分析工具和文献检索能力,但研究人员刻意没有向模型提供源论文及其结论。论文称,使用的GPT-Rosalind-5.5知识截止时间早于源研究论文发布,因此研究人员可以测试模型是否能够仅根据实验数据重建已有发现。
在这项测试中,代理识别或完善了源论文直接基于基因表达数据得出的55项发现中的48项,另有4项被部分识别。研究团队据此报告,至少部分恢复的比例达到94.5%。这类结果衡量的是对已有分析的重建能力,并不等同于模型独立证明了这些生物学结论。
代理数量带来的不是简单的“更快”
这项研究试图回答的一个问题是:让一个能力更强的代理处理全部数据,是否足以替代数千个代理并行工作?
研究人员在保持模型和资源条件不变的情况下比较了两种方式。随着任务规模扩大,单个代理检索到的文献数量增长有限;在最大工作量下,它只引用了11篇文献,而分布式代理引用了700多篇。论文摘要则称,分布式代理的文献覆盖量是单代理模式的数百倍。
这说明并行化的价值不只是把同一项工作切成更小的部分,也在于让系统能够同时探索大量相互关联但并不完全相同的生物学问题。一个代理可以关注某个基因在神经元中的表达变化,另一个代理则可能检索该变化与蛋白质稳态、细胞压力或疾病机制之间的联系。
在盲法比较中,生物学专家有75%的时间更偏好分布式代理生成的解释,而不是单个代理生成的报告。专家同时对分布式系统提出的发现排序表示支持。不过,这仍然是对报告质量和研究价值的判断,不是对假设已经得到实验确认的判断。
从Tsc1和Tsc2到神经退行性疾病线索
OpenAI给出的一个例子涉及Tsc1和Tsc2。这两个基因共同参与调节mTOR通路,而mTOR与细胞生长、代谢和衰老有关。
在多个神经元群体中,扰动两个基因产生了相似效果。但在小脑中,Tsc2扰动改变了数十个与神经元通信有关的基因,而Tsc1扰动产生的变化相对有限。研究团队认为,这种差异可能与结节性硬化症中的疾病表现有关,因为TSC2突变与小脑异常之间存在较强联系。
这项分析没有提出可以直接用于治疗的药物。它提出的是更具体的实验问题:现有抑制mTOR的药物是否能够纠正其中一部分细胞变化?哪些变化可能与学习和行为困难有关?这些问题仍需要研究人员在实验室中逐一验证。
另一个例子涉及DCTN1。DCTN1突变会导致佩里综合征,这是一种带有帕金森病样症状的神经退行性疾病。AI代理注意到,在全脑基因扰动图谱中,破坏Dctn1会提高一组与胆固醇生成有关的基因表达。
代理将这一观察与既有研究联系起来,提出一个待验证的假设:DCTN1扰动是否改变了神经元内胆固醇的分布,而这种变化是否参与了神经退行性过程?如果胆固醇运输或分布异常确实发挥作用,恢复正常分布是否可能对细胞产生保护作用?
这些说法目前都应被视为研究线索,而不是疾病机制已经得到证实。AI系统可以把分散在不同领域的证据连接起来,却不能替代对因果关系的实验检验。
生物学实验的数据增长,正在超过人工解读能力
这项工作的背景是,生物实验正在产生越来越多、越来越细的资料。全脑Perturb-seq等方法可以同时记录大量基因扰动对不同细胞类型的影响,保留组织环境、细胞差异和细胞之间的信号关系。
但数据规模扩大后,瓶颈不一定仍是实验本身,而可能是研究人员能否及时理解数据。传统统计分析可以列出差异表达基因、通路和扰动之间的相似性,却仍需要专家把这些结果与细胞类型、疾病机制和既有文献联系起来。
PerturbAI在一份由公司发布的新闻稿中说,该项目使用了一个包含约800万个脑细胞的全脑CRISPR图谱。公司称,这一图谱在数月内生成,目前已被下载超过4万次;这些数字和项目进展主要来自PerturbAI自身披露。
公司还表示,OpenAI与PerturbAI将把这套推理框架进一步用于药物靶点发现。需要注意的是,“用于发现靶点”不等于已经确认靶点有效,更不等于已经出现临床候选药物。药物研发还要经过重复实验、药理和毒理研究、生产工艺验证、临床试验以及监管审查。
此前,OpenAI已经把GPT-Rosalind定位为面向生物学、药物发现和转化医学的专用模型。其官方模型介绍称,GPT-Rosalind可以用于文献综述、序列分析、实验规划和数据分析,并通过研究插件连接50多个科学工具和数据来源。OpenAI同时强调,生命科学模型采取可信访问机制,面向经过审核的机构和研究组织。
AIFlux此前对OpenAI收购Orchestra Bio的报道也指出,OpenAI在生命科学领域的布局正从回答研究问题,扩展到连接证据、实验和项目流程。此次分布式代理研究展示的,则是其中更靠近数据分析和假设生成的一层。
AI可以扩大搜索范围,但不能跳过验证链
这项研究最重要的限制,是它仍停留在计算分析和预印本阶段。代理能够重建一部分已有结论,并提出专家认为值得跟进的新线索,但研究团队还没有证明这些新线索能够在独立实验中复现,更没有证明它们可以转化为治疗效果。
另一个限制是,代理报告的质量依赖输入数据、检索文献和评估方法。分布式系统可能覆盖更多文献,也可能因此引入更多噪声。报告之间的合并、证据等级判断和发现排序,都需要研究人员审查。
这也是为什么AIFlux在谷歌用AI研究疾病的报道中反复强调,虚拟筛选、遗传分析或疾病预测的结果,都不能直接等同于临床获益。对生物医学研究来说,真正的转化链条仍然包括实验重复、同行评审、临床验证和监管判断。
OpenAI、PerturbAI和Scripps Research的工作所展示的,或许不是一种能够独立完成科学发现的机器,而是一种扩大研究人员注意力范围的工具:让更多扰动得到解释,让更多文献被连接起来,让一些原本容易被忽略的异常信号进入后续实验清单。
如果这种方法能够在不同数据集、不同实验室和不同生物学问题上稳定复现,它可能改变大规模实验的使用方式。实验不再只是产生一份等待专家筛选的结果,而是可以同步生成一套带有证据、局限和优先级的研究地图。
但从一张研究地图走到一种安全有效的治疗方案,中间仍有很长的路。AI能够缩短提出问题和整理证据的时间,却不能替研究人员承担因果验证、风险判断和对患者负责的责任。